
Présentation de Trio — Un modèle du monde pour les opérations physiques

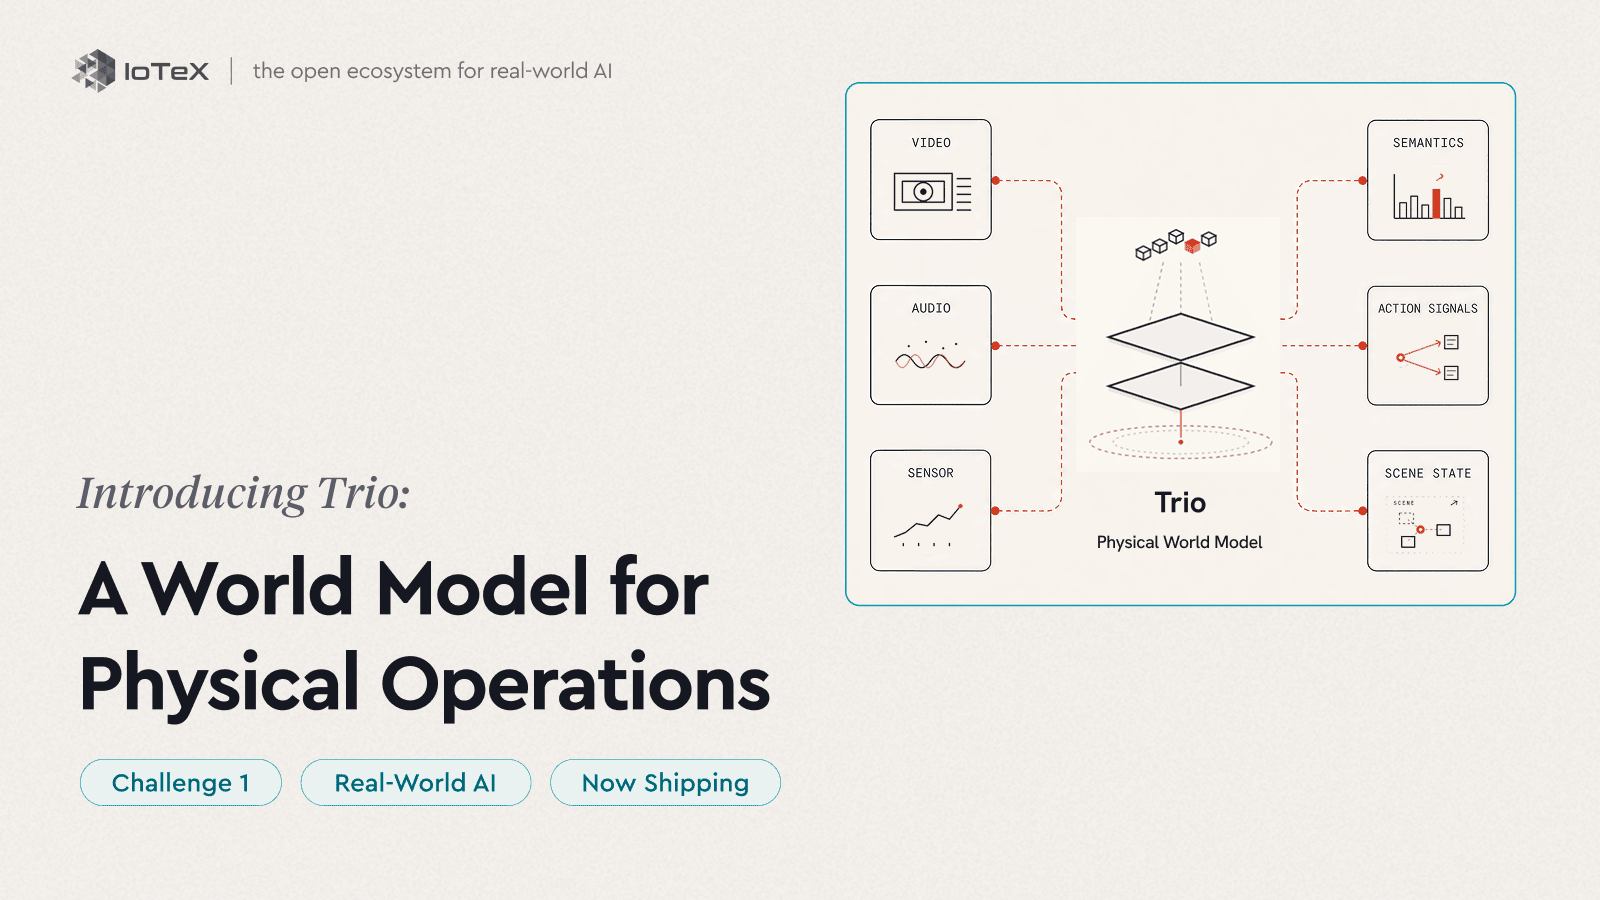
Une mise à jour d’IoTeX sur Trio, l’IA du monde réel, et notre réponse au premier défi de l’Anti-Roadmap.
En mars, IoTeX a publié son Anti-Roadmap pour 2026 — trois défis au lieu d’un calendrier. Le Défi 1 était le défi existentiel : devenir l’interface de l’IA vers le monde physique. Notre réponse était concrète — la vision d’abord, transformer tout flux en direct en intelligence sur laquelle vos opérations physiques peuvent agir en temps réel. Cette réponse, c’est Trio, un modèle du monde pour les opérations physiques, construit au MachineFi Lab par l’équipe principale derrière IoTeX. Nous avons relevé le défi, et maintenant nous livrons.
Depuis toujours, le monde physique a été géré par des personnes. Une personne observe ce qui se passe, juge ce que cela signifie, et agit en conséquence — conduit le camion, travaille sur la ligne, parcourt le plancher. Percevoir, prédire, agir : cette boucle a toujours eu besoin d’un humain.
L’IA a d’abord changé le monde numérique — le langage, le code, les images. Maintenant, elle commence à changer le monde physique. Une IA qui conduit une voiture dans un trafic en direct. Une IA qui apprend un jeu vidéo en imaginant comment il se joue. Un robot qui plie une pile de linge. Ce qui se cache sous tout cela — ce qui permet à une machine d’observer une situation, d’imaginer ce qui va se passer ensuite, et d’agir en conséquence — c’est un modèle du monde. Trio est un nouveau type de modèle du monde : celui qui donne à l’IA des yeux sur toute une opération, en direct.
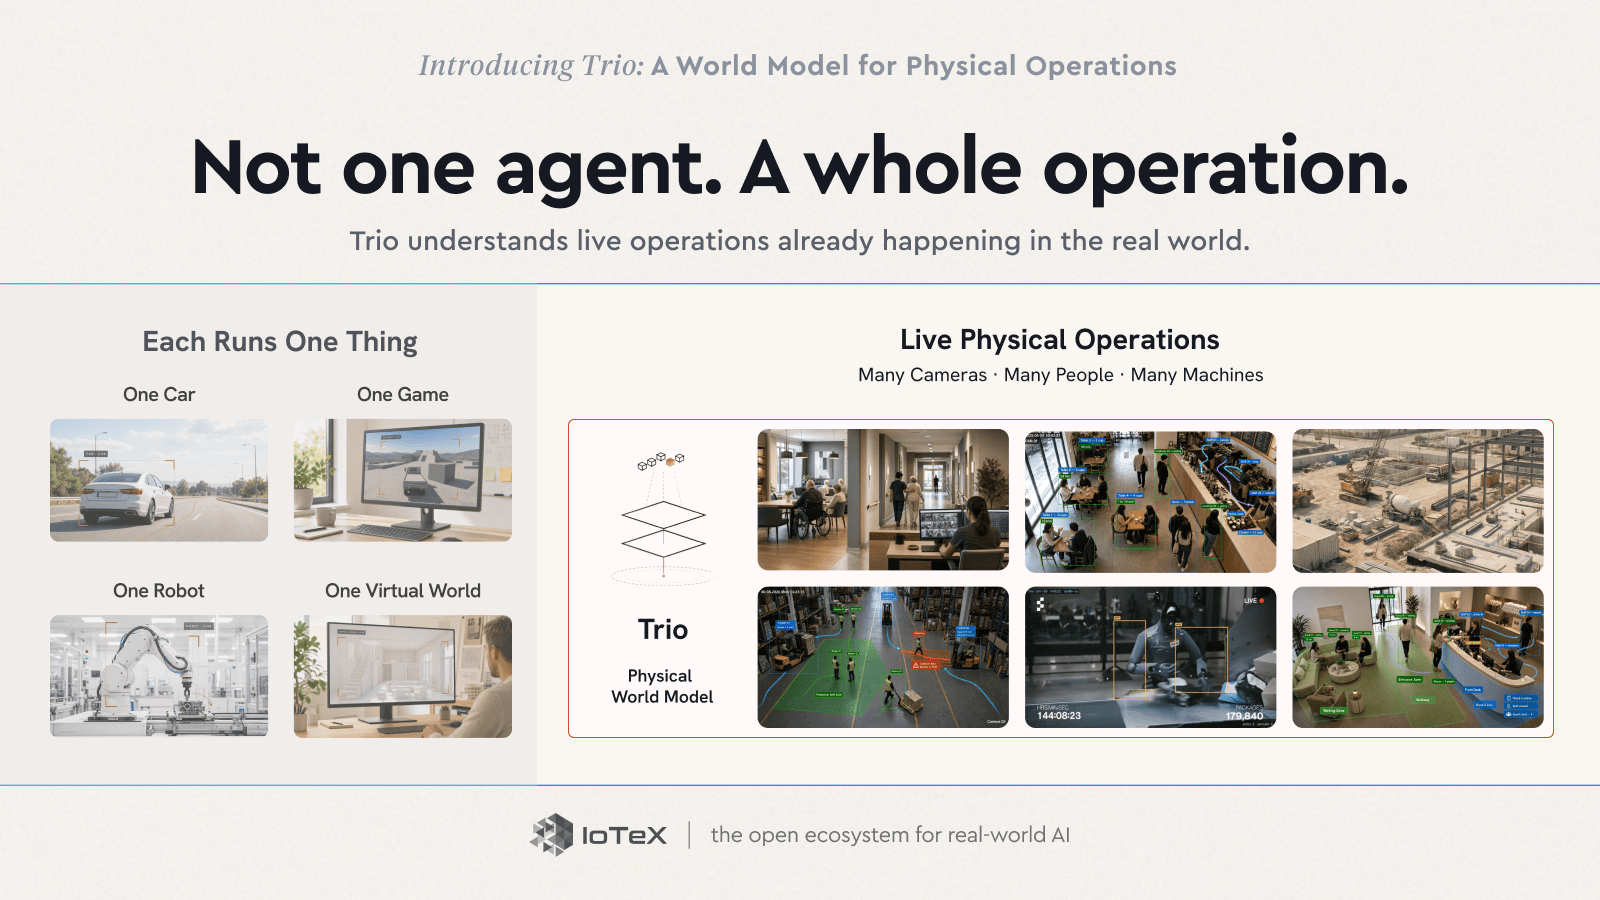
Ces autres exemples sont volontairement restreints : une voiture, un jeu, un robot, une tâche. Mais la plus grande surface physique de toutes est déjà connectée et surveillée — les caméras au-dessus de chaque entrepôt, magasin, usine et espace de soins… Un modèle du monde qui fonctionne sur celles-ci — sur des opérations entières, en direct — est exactement l’interface que le Défi 1 appelait de ses vœux. C’est ce pour quoi Trio est conçu.
Ce qu’est Trio
Remarquez ce que ces quatre exemples ont en commun : chacun gère une seule chose — une voiture, un jeu, un robot, un monde virtuel. Aucun d’eux ne gère une opération. Et c’est là que vit réellement la majeure partie de l’économie physique — un restaurant à l’heure du déjeuner, un lave-auto faisant défiler les voitures dans ses baies, un entrepôt chargeant des camions, un magasin faisant tourner son personnel, une chaîne de production dans une usine — des lieux avec des dizaines de personnes, de véhicules et de machines en mouvement simultané, 24 heures sur 24, tous filmés par des caméras que personne n’a le temps de surveiller.
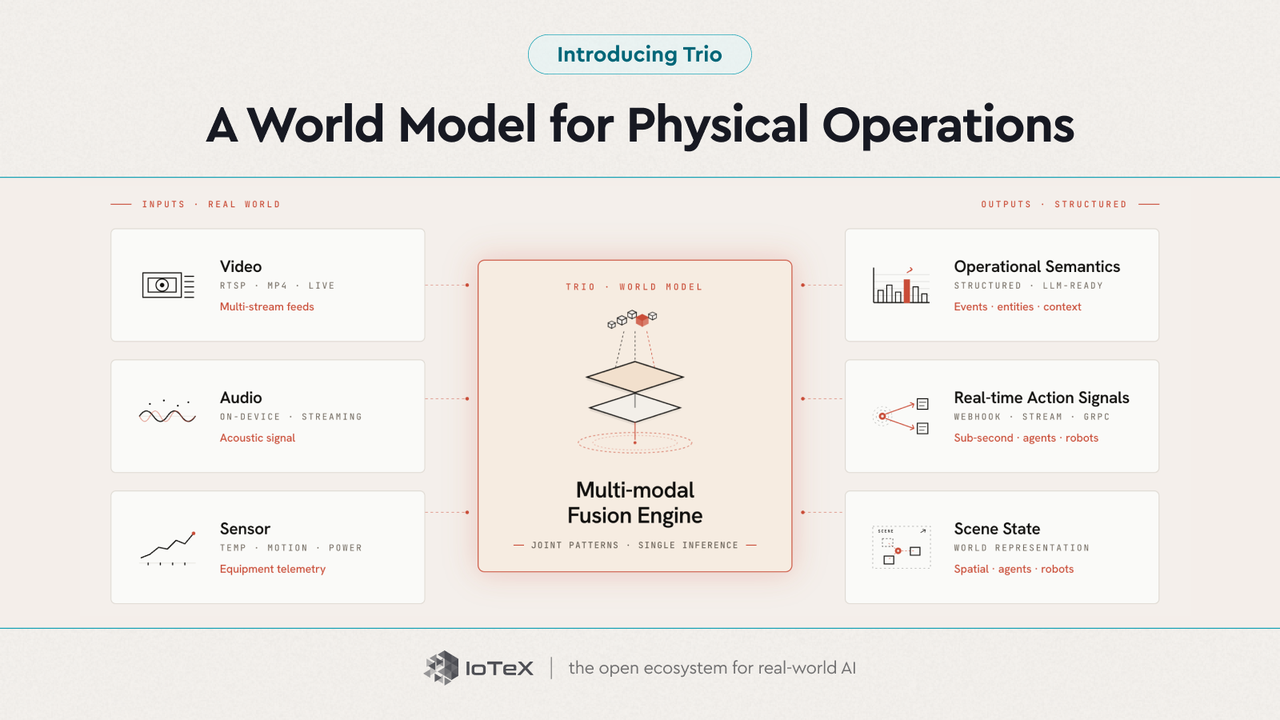
C’est à cela que sert Trio. Trio est notre modèle du monde pour les opérations physiques — non pas un modèle monolithique unique, mais une suite de trois produits qui, ensemble, perçoivent, prédisent et agissent sur une opération en direct. Là où un modèle de langage apprend comment fonctionne le texte, Trio apprend comment fonctionne un lieu — ce qu’il contient, comment il évolue, ce qui va se passer ensuite — pour votre opération, à partir des caméras et capteurs que vous possédez déjà. Nous ne remplaçons pas les modèles de langage ; nous leur donnons le monde physique.
Trio exécute cette boucle en trois étapes — et elle est livrée dans cet ordre. La perception est disponible dès aujourd’hui ; la prévision et l’action sont les prochaines étapes.
PERCEPTION → PRÉDICTION → ACTION
- Perception — Voir · Comprendre — Trio-Retina · Trio-Lumen — Disponible maintenant
- Prédiction — Prévoir · raisonner à l’avance — Prochainement
- Action — Boucler la boucle — Plus tard
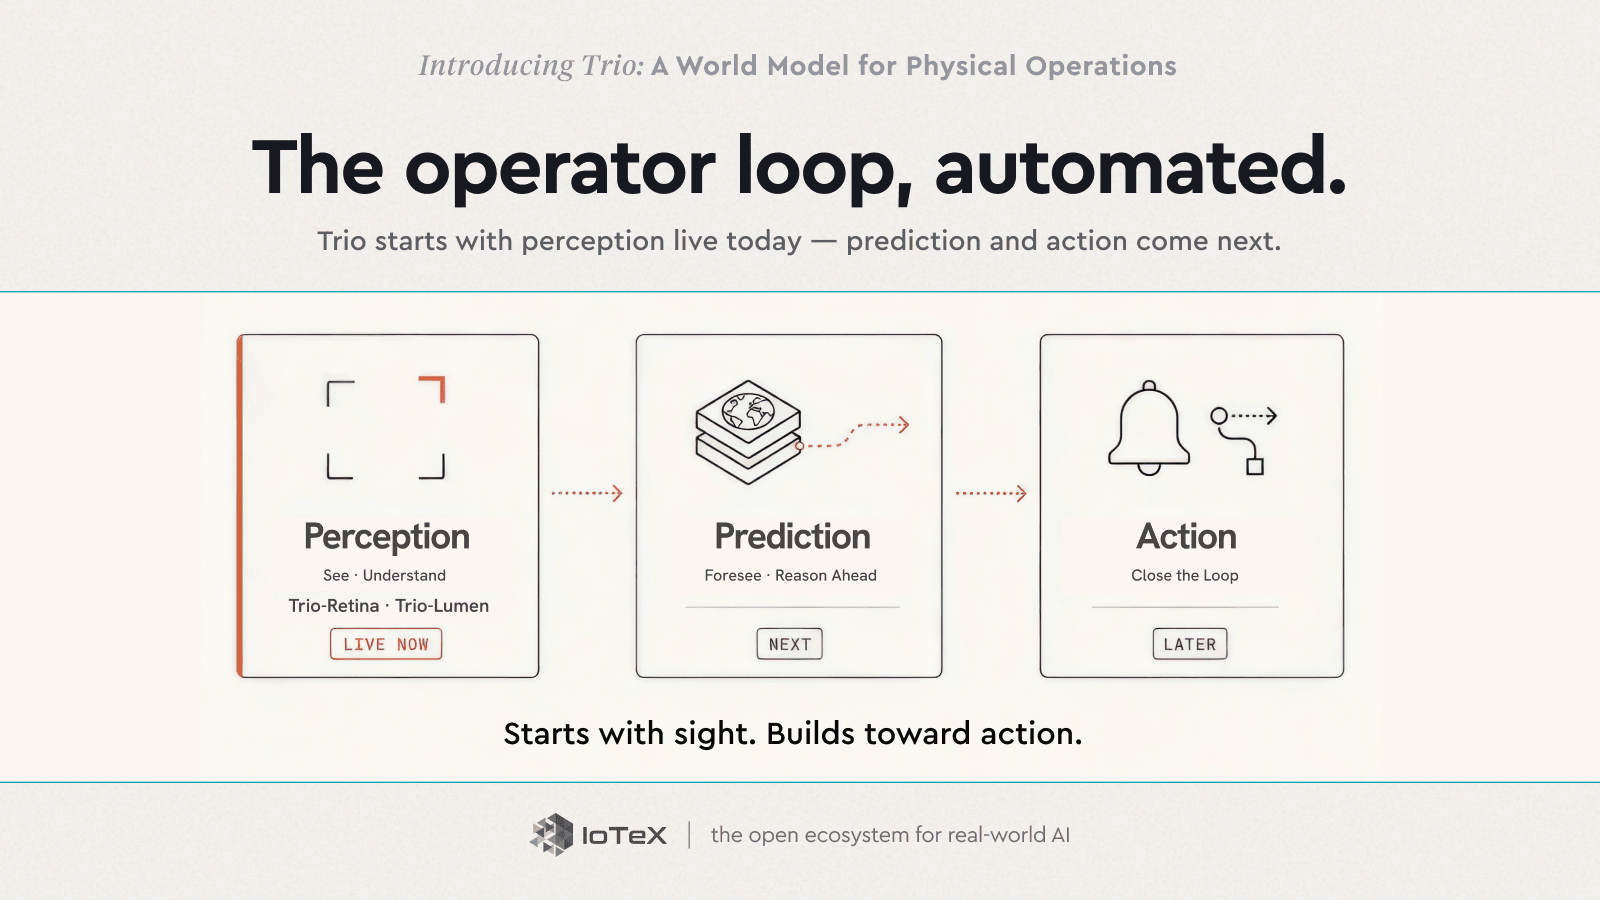
Aujourd’hui, deux de ces éléments sont réels et entre vos mains. Trio-Retina (Voir) transforme n’importe quel flux de caméra en une lecture unique et standardisée, en direct, de ce qui se passe — qui est où, ce qu’ils font, où ils se dirigent. Trio-Lumen (Comprendre) rend cela programmable en langage courant — « signalez toute personne présente sur le quai de chargement après les heures d’ouverture » — en surveillant chaque image 24 heures sur 24, et en la transformant en événements et alertes. Perception et compréhension, disponibles dès aujourd’hui.
pip install trio-retinaTrio-Retina est open source — il fonctionne sur votre propre machine, ou vous pouvez l’essayer en direct dans le Playground.
Ces deux éléments constituent le socle sur lequel le reste est construit. La prévision et l’action — anticiper les problèmes avant qu’ils ne surviennent, puis agir sur le terrain — sont les étapes suivantes de la boucle. L’ordre est délibéré : on ne peut pas prévoir ce qu’on ne peut pas encore voir, c’est pourquoi nous avons d’abord construit la vue.
Un modèle entraîné sur l’internet ouvert apprend à quoi ressemble le monde. Trio apprend comment fonctionne votre exploitation.
À Quoi Cela Ressemble Dans Un Entrepôt
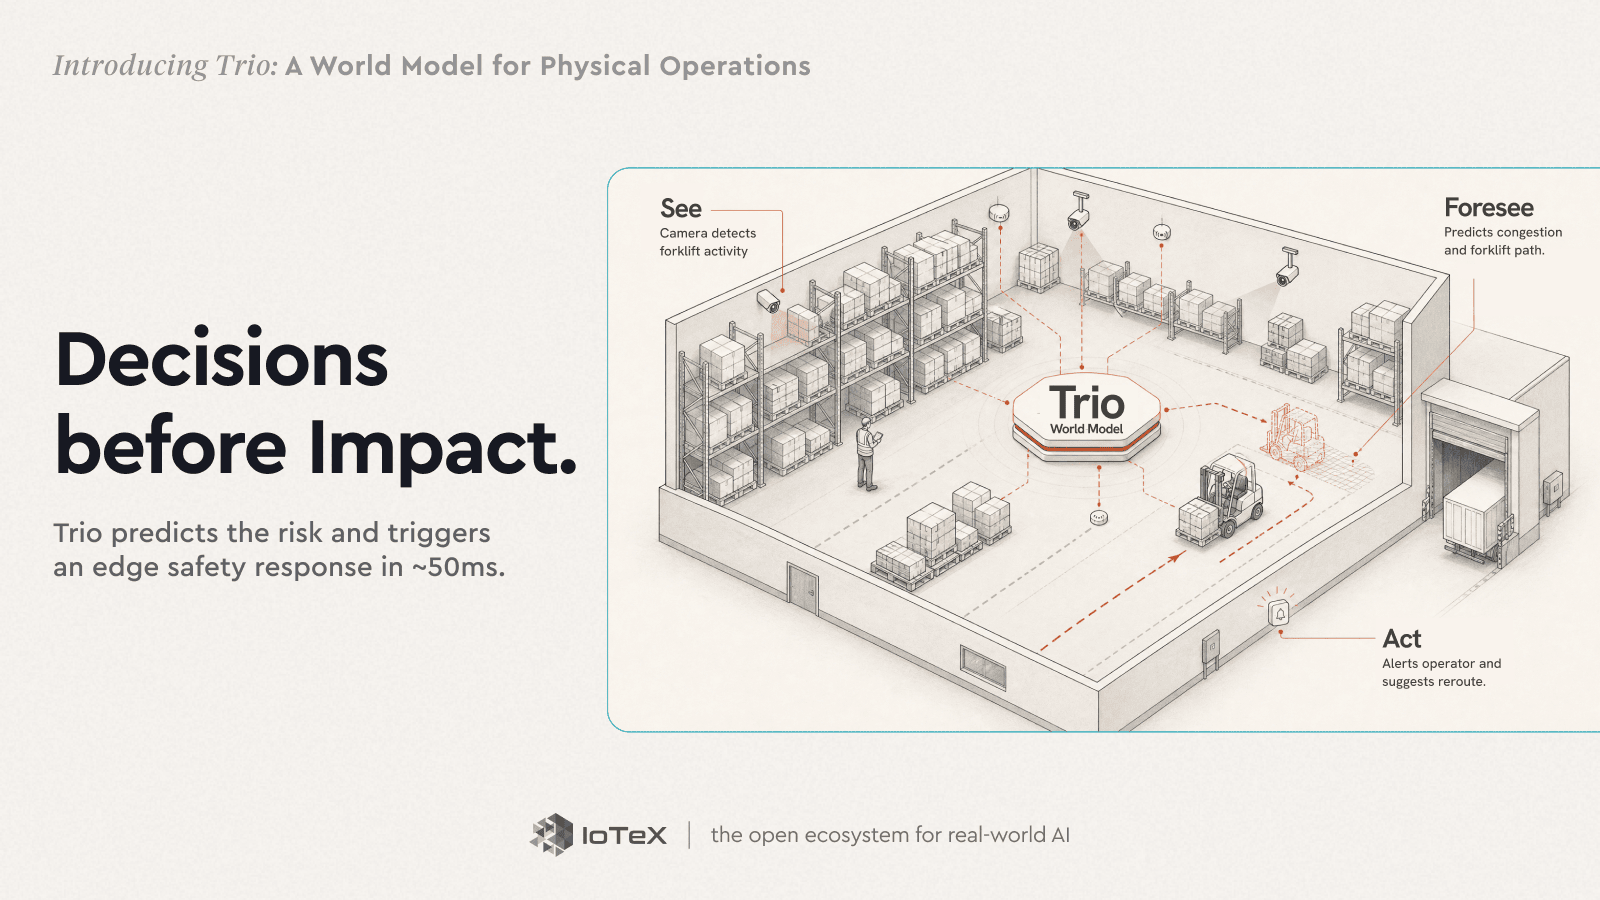
Retirons l’abstraction. Un quai de chargement, en plein service. Un chariot élévateur recule pour sortir d’une baie ; un travailleur sort d’entre deux rayonnages sur un chemin qui croise le sien. Ni l’un ni l’autre ne peut encore voir l’autre.
Voir — Trio-Retina, fonctionnant sur un petit boîtier à côté de la caméra, a déjà identifié les deux comme des objets suivis : le chariot élévateur et la personne, leurs positions, et la direction que prend chacun.
Prévoir — Le modèle du monde de Trio projette les deux prochaines secondes. Les deux trajectoires se croisent. Il a déjà vu cette géométrie exacte mal se terminer auparavant.
Agir — une porte de sécurité déterministe en périphérie déclenche l’alarme d’intersection en environ 50 millisecondes — plus rapide que ce qu’une personne pourrait réagir — et le chariot élévateur reçoit le signal de s’arrêter. Un quasi-accident évité au lieu d’un rapport d’incident.
C’est toute la thèse en une seule image : non pas des images que l’on consulte après qu’un événement se soit produit, mais une décision prise l’instant avant qu’il ne survienne.
Un Véritable Modèle Du Monde — Et En Quoi Le Nôtre Est Différent
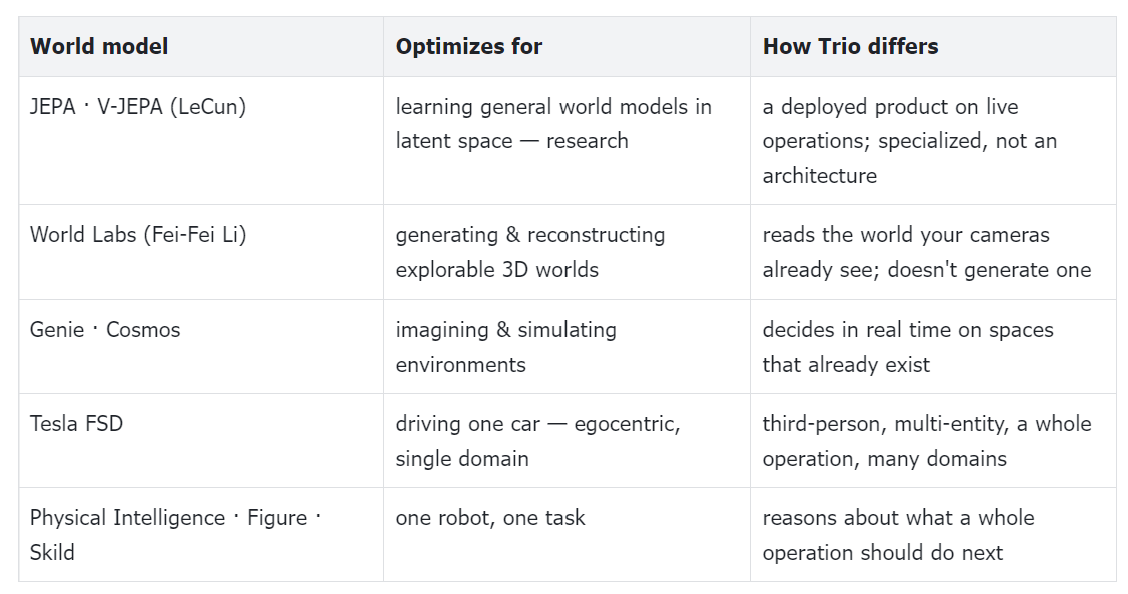
Trio s’inscrit dans un domaine en évolution rapide. Les modèles du monde sont l’un des sujets où se concentrent aujourd’hui certains des meilleurs esprits de l’IA. L’idée remonte à World Models (2018) de Ha & Schmidhuber — un agent apprenant un modèle compact de son environnement et « rêvant » des déroulements à l’intérieur de celui-ci. Yann LeCun soutient qu’un modèle du monde prédictif dans un espace latent (son JEPA) est la pièce manquante sur le chemin vers une intelligence machine autonome ; Fei-Fei Li appelle cette frontière l’intelligence spatiale, et son entreprise World Labs construit des modèles générant des mondes 3D explorables. Le domaine se divise globalement en plusieurs camps :
- Prédiction latente — V-JEPA 2 (Meta) et la lignée Dreamer apprennent la dynamique dans un espace latent et y planifient.
- Mondes génératifs et interactifs — Genie 3 (DeepMind), NVIDIA Cosmos, et Marble de World Labs imaginent et génèrent des environnements.
- Conduite autonome — Tesla FSD et GAIA-2 de Wayve font fonctionner les modèles du monde les plus déployés sur Terre — pour une seule voiture.
- Robotique — Physical Intelligence, Skild AI, et Figure construisent des modèles de fondation pour un seul robot.
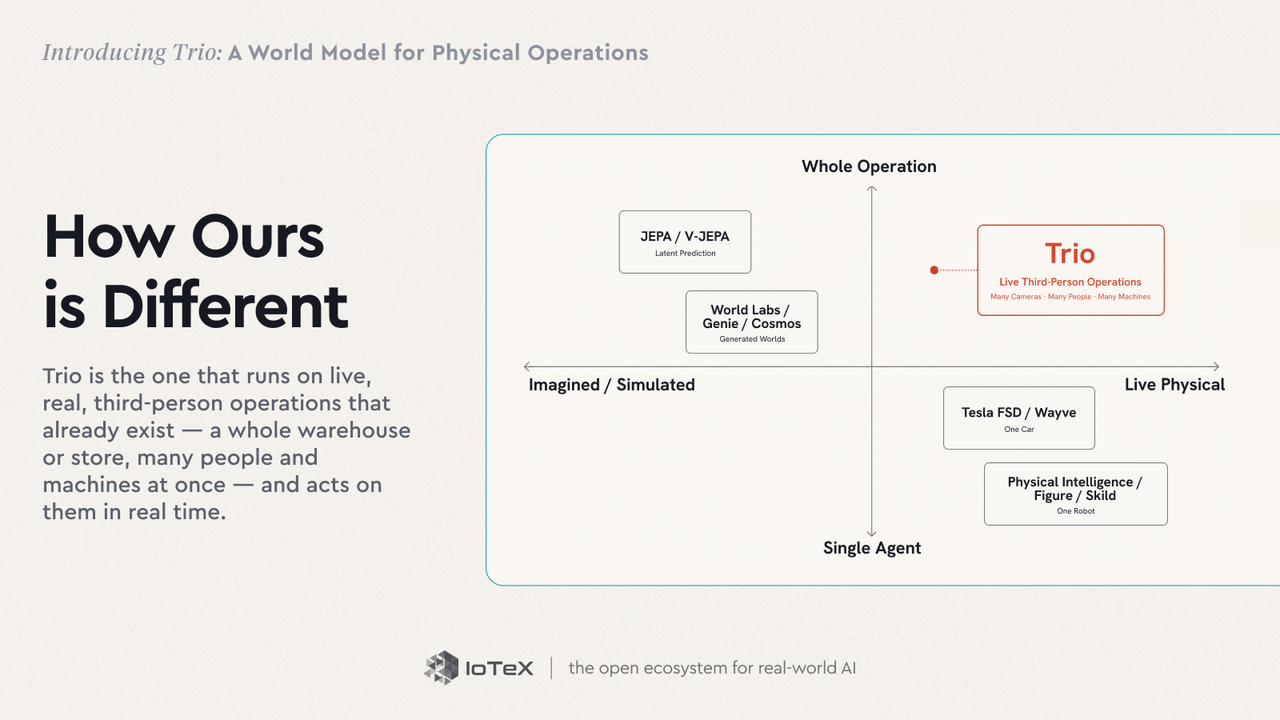
Presque tous imaginent ou simulent un monde, ou modélisent le domaine égocentrique d’un seul agent — une voiture, un robot. Trio est celui qui fonctionne sur des opérations réelles, en direct, à la troisième personne, qui existent déjà — un entrepôt ou un magasin entier, de nombreuses personnes et machines à la fois — et agit sur elles en temps réel.
Deux axes distinguent Trio. Sur le plan technique — c’est petit, rapide et spécialisé : temps réel en périphérie, un plancher proche de 0,004 $ par requête, facturé à la décision, une fondation gelée plus de petits adaptateurs par site (LoRA, entraînés en heures-GPU) plutôt qu’un modèle général géant relancé à chaque image. Sur le benchmark de streaming OVBench, intégrer un modèle à poids ouverts dans la pile de Trio augmente la précision de +2,3 points uniquement grâce à l’architecture, et sa perception fonctionne en flux continu sans les limites de durée fixes auxquelles se heurtent les modèles de pointe. Sur le plan des scénarios — cela fonctionne sur les opérations qui existent déjà, et agit sur elles dès maintenant, au lieu d’imaginer un monde, de conduire une voiture, ou de déplacer un robot.
Comment Trio est construit
Pour les équipes techniques : voici comment Trio reste assez rapide et économique pour fonctionner sur chaque caméra, toute la journée. Si vous êtes ici pour l’histoire des opérations, avancez rapidement — la conclusion se trouve à la dernière ligne.
Cinq principes maintiennent le système ensemble : chaque interface entre les couches est un graphe de scène fortement typé et inspectable (jamais un vecteur opaque) ; un routeur gère le coût, exécutant en continu les couches peu coûteuses et n’activant le raisonnement coûteux qu’en cas de besoin ; les outils sont bidirectionnels, de sorte que la couche de raisonnement puisse ordonner aux couches inférieures de réexaminer ou de resimuler ; chaque décision est accompagnée de ses preuves, afin qu’un opérateur puisse l’inspecter, la contester et la remplacer ; et les modèles de fondation restent gelés tandis que de petits adaptateurs par déploiement — modules LoRA et un adaptateur de fusion inter-niveaux, entraînés en heures-GPU plutôt que par un réentraînement complet — spécialisent chaque site.
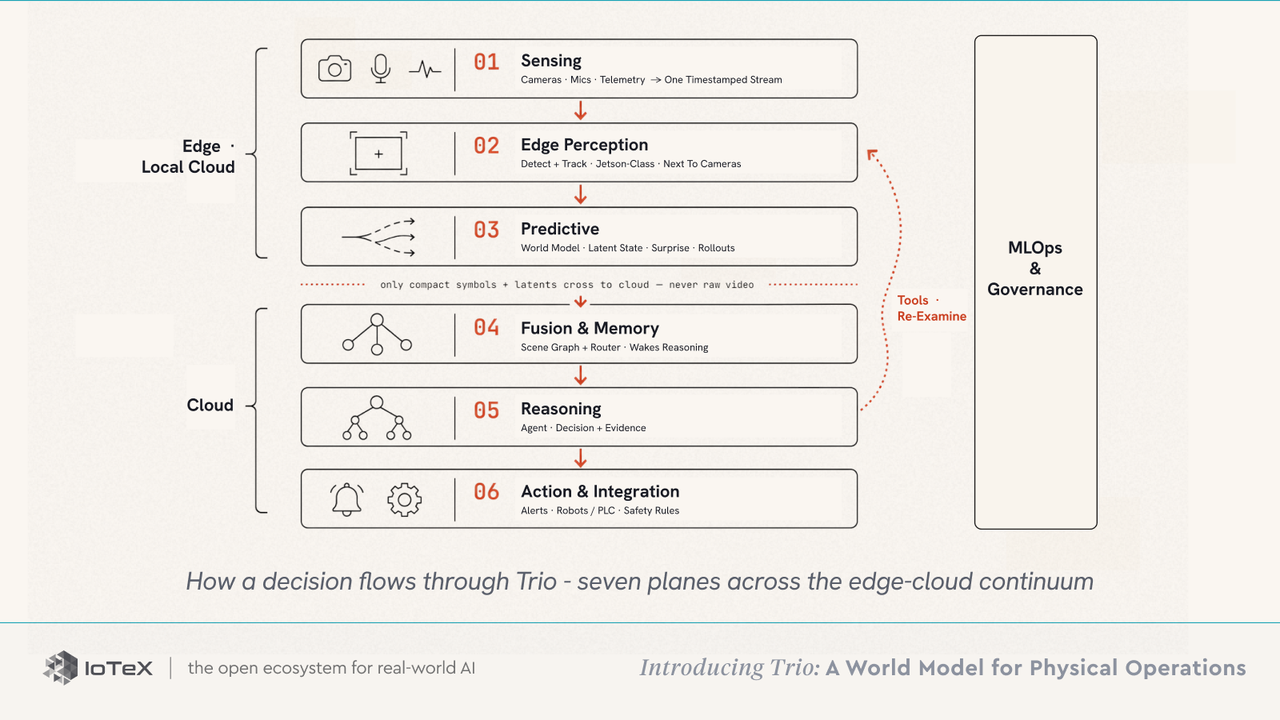
Ces principes se concrétisent en sept plans — six dans le chemin d’une seule décision, plus la gouvernance sur l’ensemble : Détection (caméras · micros · télémétrie → un seul flux horodaté) → Perception en périphérie (détection + suivi, classe Jetson, à côté des caméras) → Prédictif (modèle du monde : état latent · surprise · projections) → Fusion et mémoire (graphe de scène + routeur qui active le raisonnement) → Raisonnement (agent → décision associée à ses preuves) → Action et intégration (alertes · robots / automates · règles de sécurité indépendantes), avec MLOps et gouvernance sur l’ensemble.
Parce que la perception et la prédiction s’exécutent localement et que seuls des symboles compacts et des états latents voyagent vers le cloud — jamais de vidéo brute — Trio est facturé à la décision, pas au token par image.
Où Trio fonctionne
L’entrepôt n’était qu’une image. Le restaurant, le lave-auto, le magasin, l’usine par laquelle nous avons commencé — le même modèle s’applique à toute opération qui fonctionne avec des caméras, dès aujourd’hui aux côtés des opérateurs humains, en mettant en lumière ce que leurs systèmes existants manquent :
- Opérations de franchise — Gestion des files d’attente, réduction des pertes, conformité des employés, analyse du flux de clients.
- Sécurité et contrôle d’accès — Détection d’intrusion, analyse de flânerie, prévention du talonnage, application des règles hors heures d’ouverture.
- Logistique et entreposage — État des quais, temps de stationnement des véhicules, conformité EPI, application des procédures de sécurité sur les cours et les sols.
- Fabrication et industrie — Surveillance des lignes, détection de défauts, alertes de danger sur chaque ligne et zone de machines.
- Villes intelligentes — Stationnement, flux de circulation, sécurité publique, surveillance des infrastructures dans les rues et les transports.
- Santé et sciences de la vie — Détection des chutes, schémas d’occupation, surveillance comportementale dans les chambres des résidents et les campus.
- Hôtellerie et lieux d’événements — Gestion des foules, contrôle d’accès aux zones VIP, réponse aux incidents en temps réel à grande échelle.
- Infrastructures critiques — Intelligence périmétrique 24h/24 et 7j/7, détection d’intrusion, réponse autonome pour les sites qui ne peuvent se permettre de manquer une alerte.
Ce que nous avons construit — et ce qui suit
Trio n’est plus une thèse sur un tableau blanc. Le rapport technique v1.0 formalise le système complet — la pile perception–prédiction–action, cinq principes, sept plans — avec deux domaines de référence entièrement développés (un lave-auto et un entrepôt), jusqu’au quasi-accident chariot élévateur-piéton mentionné plus haut, capté par une porte de sécurité déterministe en périphérie qui se déclenche en environ 50 millisecondes, bien en deçà du plafond de 100 ms. Trio-Retina est open source (pip install trio-retina), et le Playground est en ligne — ouvrez-le et regardez Trio analyser des images réelles dans votre navigateur.
Trois forces font que le moment est venu : le silicium en périphérie (edge) peut enfin exécuter un raisonnement opérationnel en temps réel sans aller-retour vers le cloud ; la compréhension de scènes multi-entités a franchi un seuil de recherche que la détection d’objets uniques n’a jamais approché ; et les opérateurs d’environnements physiques sont prêts pour ce qui est peut-être la capacité la plus sous-évaluée de l’IA aujourd’hui — un modèle du monde au-dessus des caméras qu’ils possèdent déjà, sans nouveau matériel. À partir de là, Trio grandit dans la boucle — de voir et comprendre aujourd’hui vers prévoir et, avec le temps, agir sur le terrain.
Commencez avec Trio dès aujourd’hui
Deux façons d’y entrer — toutes deux disponibles dès maintenant :
CONSTRUISEZ DESSUS · DÉVELOPPEURS — Trio-Retina sur GitHub. La couche de perception open-source — la couche d’état agnostique au modèle qui transforme n’importe quel détecteur en un flux standard unique d’événements plus état latent. pip install trio-retina et exécutez-le sur votre propre machine.
EXPÉRIMENTEZ · OPÉRATEURS — Trio-Lumen sur la plateforme. Voyez votre opération prendre vie dans le navigateur — Trio lisant des images réelles comme des objets avec état et des foules comme des flux, puis pointez-le vers vos propres caméras et posez des questions en langage clair.
Trio, IoTeX, et l’économie des machines
Trio ne sort pas de nulle part. Il est construit sur une décennie d’IoTeX — l’infrastructure et le réseau d’appareils connectés, les identités d’appareils (ioID), les données machine vérifiables (Quicksilver), et les paiements machine-à-machine (x402) dont l’IA du monde réel a besoin pour s’ancrer dans le monde avec des données, une identité et une confiance derrière elle. Et Trio est le produit qui concrétise la vision d’IoTeX : le Défi 1 avait pour objectif de faire d’IoTeX l’interface à travers laquelle l’IA voit, vérifie et agit sur le monde physique, et Trio, c’est la vision.
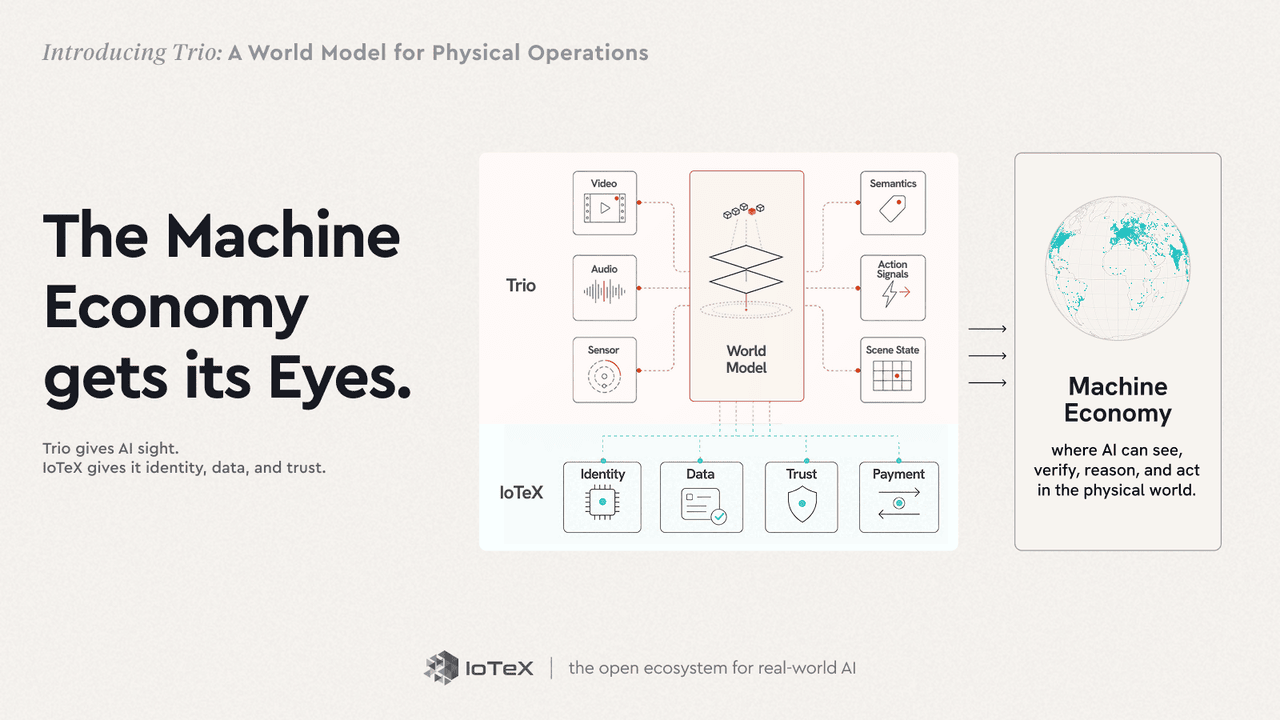
Mettez tout cela ensemble et vous obtenez l’économie des machines décrite par l’Anti-Roadmap. Les machines ont besoin de trois choses : voir le monde, faire confiance à ce qu’elles voient, et agir en conséquence. IoTeX fournit la confiance décentralisée, tandis que Trio fournit les yeux et les oreilles pour percevoir la réalité physique — et le cerveau pour raisonner et agir sur elle.
Continuons à livrer…
Le Défi 1 a maintenant une réponse. Donner à l’IA des yeux sur le monde physique et le rendre réel — c’était le premier et le plus existentiel des défis de notre Anti-Roadmap pour 2026. Nous avons trouvé la voie, et nous construisons à plein régime depuis. Trio est une IA du monde réel qui livre, pas une simple présentation — elle fonctionne sur les caméras déjà en place et les transforme en valeur dès le premier jour.
Le lancement officiel est proche, et l’avenir que nous avons promis est presque entre nos mains. Merci de construire avec nous et restez à l’écoute.
— L’équipe IoTeX
Pour aller plus loin sur les modèles du monde
- D. Ha, J. Schmidhuber. World Models. 2018.
- Y. LeCun. A Path Towards Autonomous Machine Intelligence. 2022. (introduit JEPA)
- F.-F. Li. From Words to Worlds: Spatial Intelligence is AI’s Next Frontier. 2025. (World Labs)
- D. Hafner, W. Yan, T. Lillicrap. Training Agents Inside of Scalable World Models (DreamerV4). 2025.
- Meta AI. V-JEPA 2. 2025.
- DeepMind. Genie 3. 2025.
- NVIDIA. Cosmos World Foundation Model Platform for Physical AI. 2025.
- Wayve. GAIA-2: a controllable multi-camera world model for driving. 2025.