
Memperkenalkan Trio — Model Dunia untuk Operasi Fisik

Pembaruan status IoTeX tentang Trio, AI dunia nyata, dan jawaban kami terhadap tantangan pertama dari Anti-Roadmap.
Pada bulan Maret, IoTeX menerbitkan Anti-Roadmap untuk 2026 — tiga tantangan, bukan garis waktu. Tantangan 1 adalah yang eksistensial: menjadi antarmuka AI ke dunia fisik. Jawaban kami konkret — visi terlebih dahulu, ubah siaran langsung apa pun menjadi kecerdasan yang dapat Anda tindak lanjuti pada operasi fisik secara real time. Jawaban itu adalah Trio, sebuah world model untuk operasi fisik, dibangun di MachineFi Lab oleh tim inti di balik IoTeX. Kami menerima tantangan ini, dan sekarang kami mewujudkannya.
Sepanjang sejarah, dunia fisik dijalankan oleh manusia. Seseorang mengamati apa yang terjadi, menilai maknanya, dan bertindak berdasarkan itu — mengemudikan truk, bekerja di lini produksi, berjalan di lantai kerja. Mengamati, memprediksi, bertindak: putaran itu selalu membutuhkan manusia di dalamnya.
AI mengubah dunia digital terlebih dahulu — bahasa, kode, gambar. Sekarang AI mulai memasuki dunia fisik. Sebuah AI yang mengemudikan mobil di tengah lalu lintas nyata. Sebuah AI yang mempelajari video game dengan membayangkan cara memainkannya. Sebuah robot yang melipat tumpukan cucian. Bagian yang mendasari semua itu — yang memungkinkan mesin mengamati situasi, membayangkan apa yang akan terjadi selanjutnya, dan bertindak berdasarkan itu — adalah world model. Trio adalah jenis world model baru: yang memberikan AI mata untuk mengamati seluruh operasi, secara langsung.
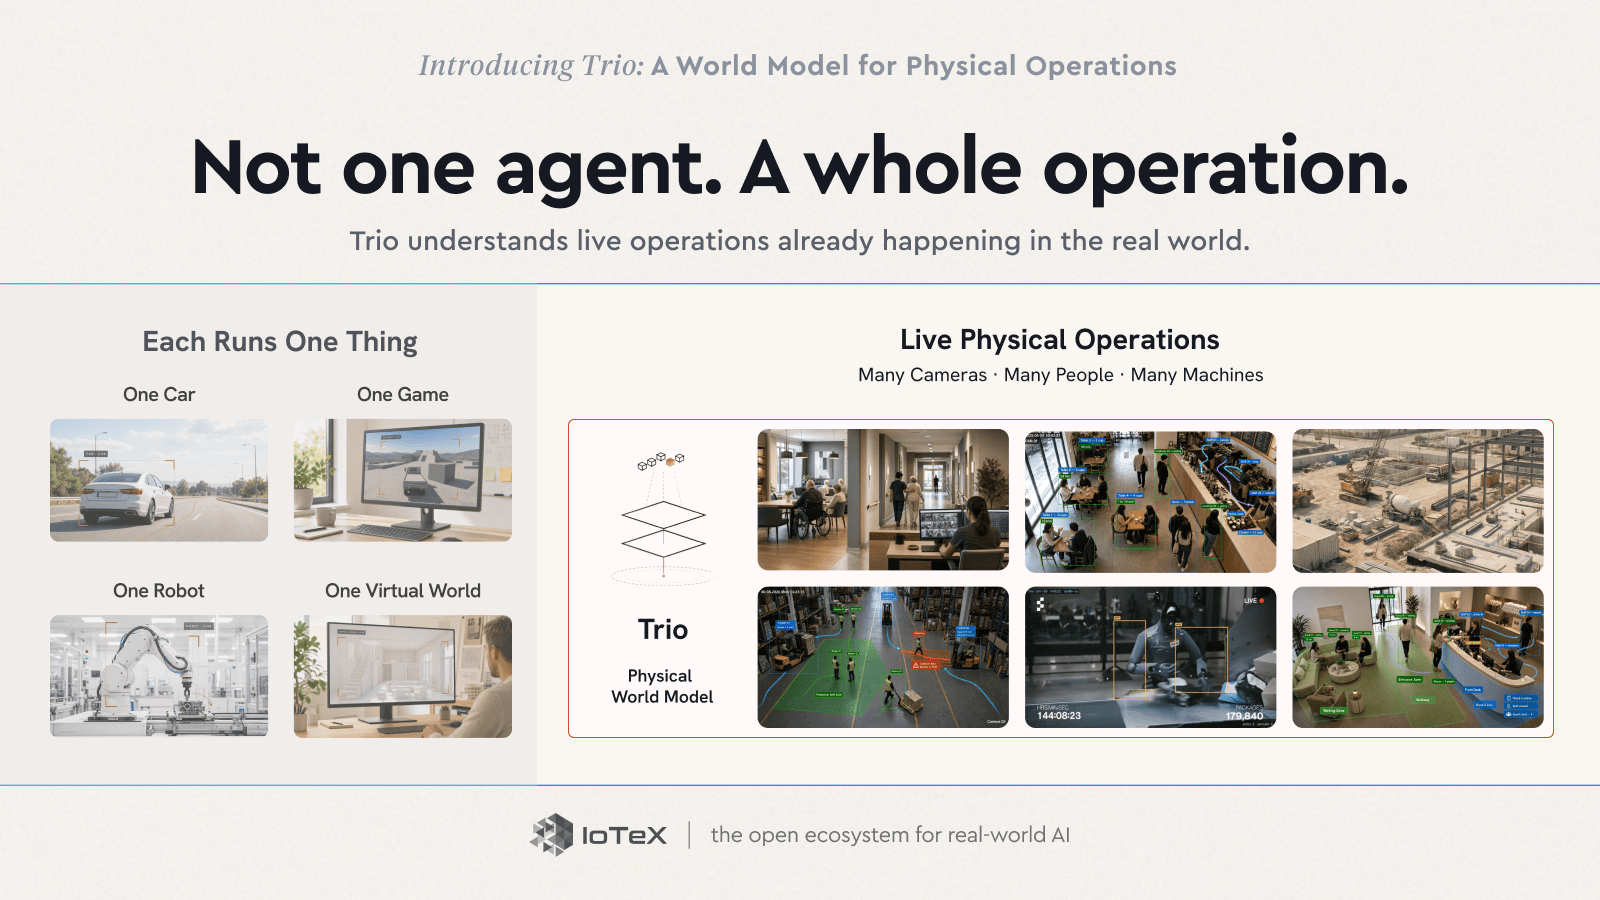
Contoh-contoh lain itu memang sengaja dibuat sempit: satu mobil, satu game, satu robot, satu tugas. Namun permukaan fisik terbesar dari semuanya sudah terhubung dan diawasi — kamera-kamera di atas setiap gudang, toko, pabrik, dan fasilitas perawatan… Sebuah world model yang berjalan pada semua itu — pada seluruh operasi, secara langsung — adalah tepatnya antarmuka yang diminta oleh Tantangan 1. Itulah untuk apa Trio dibangun.
Apa Itu Trio
Perhatikan kesamaan dari keempat contoh tadi: masing-masing hanya menjalankan satu hal — satu mobil, satu game, satu robot, satu dunia virtual. Tidak satu pun dari mereka menjalankan sebuah operasi. Dan di situlah sebagian besar ekonomi fisik sebenarnya berada — sebuah restoran saat jam makan siang yang sibuk, sebuah cucian mobil yang memutar kendaraan melalui setiap bay-nya, sebuah gudang yang memuat truk, sebuah toko yang mengelola lantainya, sebuah lini produksi pabrik — tempat-tempat dengan puluhan orang, kendaraan, dan mesin yang bergerak sekaligus, sepanjang waktu, semuanya terekam kamera yang tak sempat diawasi siapa pun.
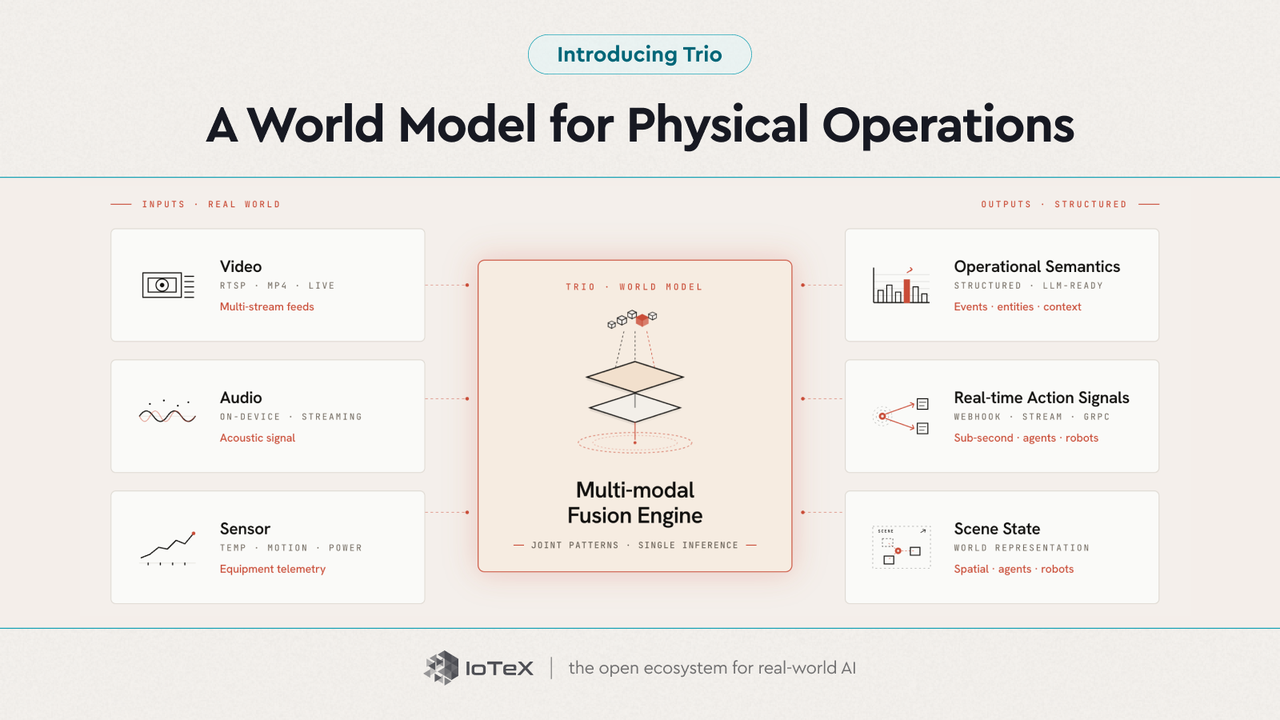
Untuk itulah Trio hadir. Trio adalah world model kami untuk operasi fisik — bukan satu model monolitik tunggal, melainkan sebuah rangkaian tiga produk yang bersama-sama mengamati, memprediksi, dan bertindak atas sebuah operasi yang berlangsung secara langsung. Jika sebuah language model mempelajari cara kerja teks, Trio mempelajari cara kerja sebuah tempat — apa isinya, bagaimana pergerakannya, apa yang akan terjadi selanjutnya — untuk operasi Anda, dari kamera dan sensor yang sudah Anda miliki. Kami tidak menggantikan language model; kami memberi mereka dunia fisik.
Trio menjalankan putaran itu dalam tiga tahap — dan diluncurkan sesuai urutan itu. Perception sudah aktif hari ini; foresight dan action adalah langkah berikutnya.
PERCEPTION → PREDICTION → ACTION
- Perception — Melihat · Memahami — Trio-Retina · Trio-Lumen — Aktif sekarang
- Prediction — Meramalkan · bernalar ke depan — Berikutnya
- Action — Menutup putaran — Nanti
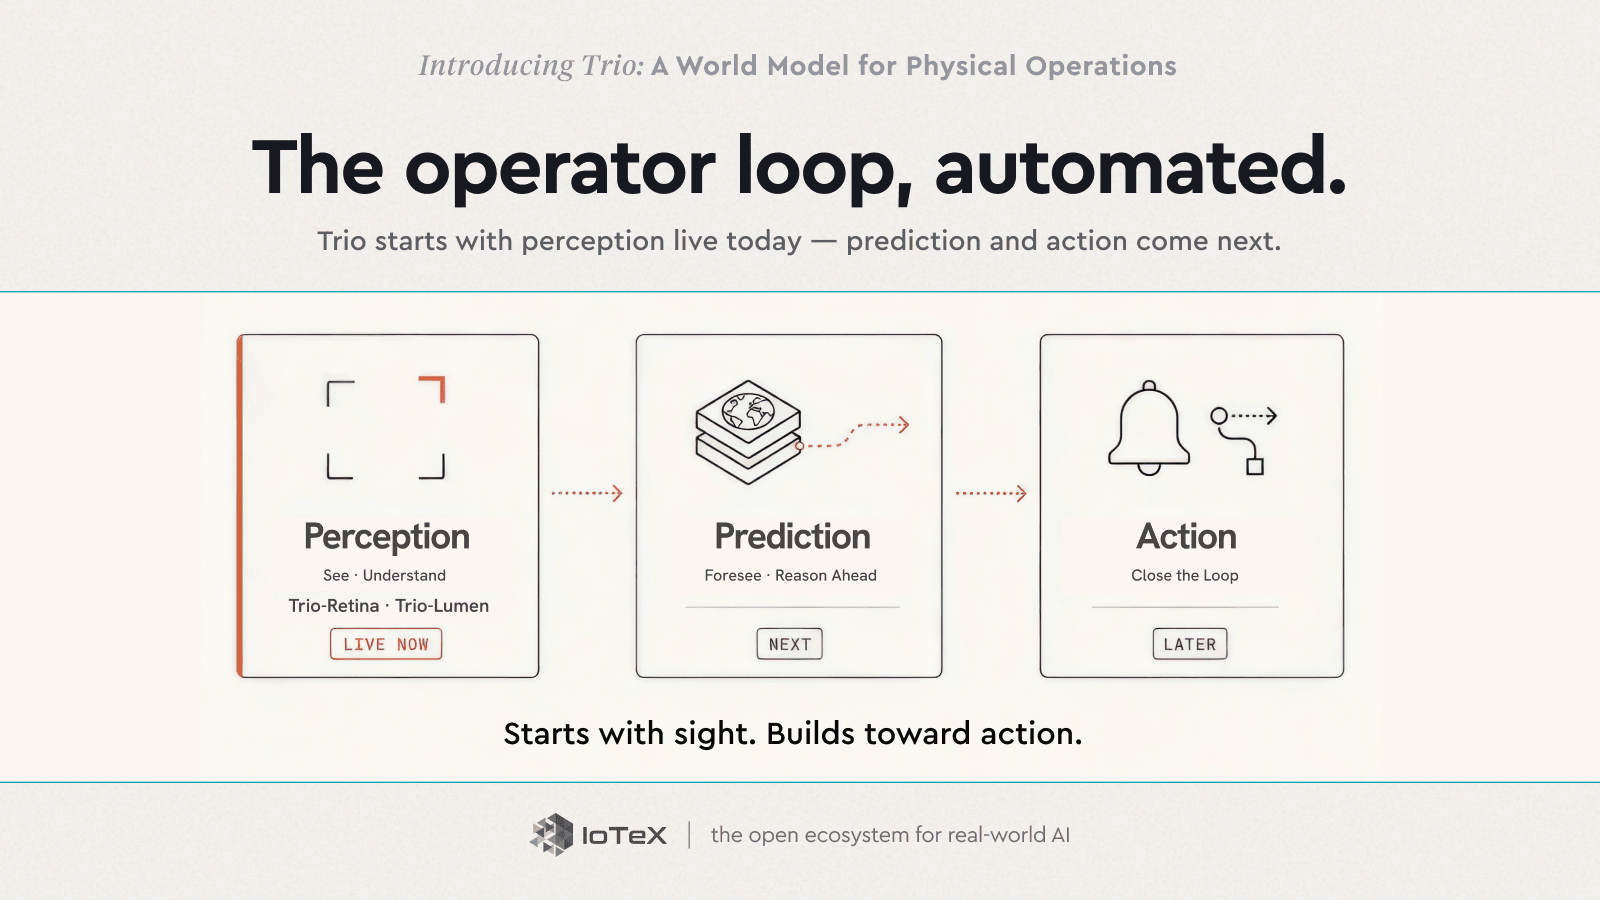
Hari ini, dua di antaranya sudah nyata dan berada di tangan Anda. Trio-Retina (Melihat) mengubah siaran kamera apa pun menjadi satu pembacaan standar dan langsung tentang apa yang terjadi — siapa di mana, sedang melakukan apa, menuju ke mana. Trio-Lumen (Memahami) membuatnya dapat diprogram dalam bahasa sehari-hari — “tandai siapa pun di dermaga pemuatan setelah jam kerja” — mengawasi setiap frame sepanjang waktu dan mengubahnya menjadi peristiwa dan peringatan. Perception dan understanding, sudah tersedia hari ini.
pip install trio-retinaTrio-Retina bersifat open source — berjalan di mesin Anda sendiri, atau coba secara langsung di Playground.
Kedua hal tersebut adalah fondasi tempat sisanya dibangun. Prediksi dan tindakan — mengantisipasi masalah sebelum terjadi, lalu bertindak di lapangan — adalah tahap berikutnya dari siklus ini. Urutannya sengaja dibuat seperti ini: Anda tidak bisa memprediksi apa yang belum bisa Anda lihat, jadi kami membangun kemampuan melihat lebih dulu.
Sebuah model yang dilatih dengan internet terbuka belajar bagaimana dunia terlihat. Trio belajar bagaimana operasi Anda berjalan.
Seperti Apa Bentuknya di Satu Gudang
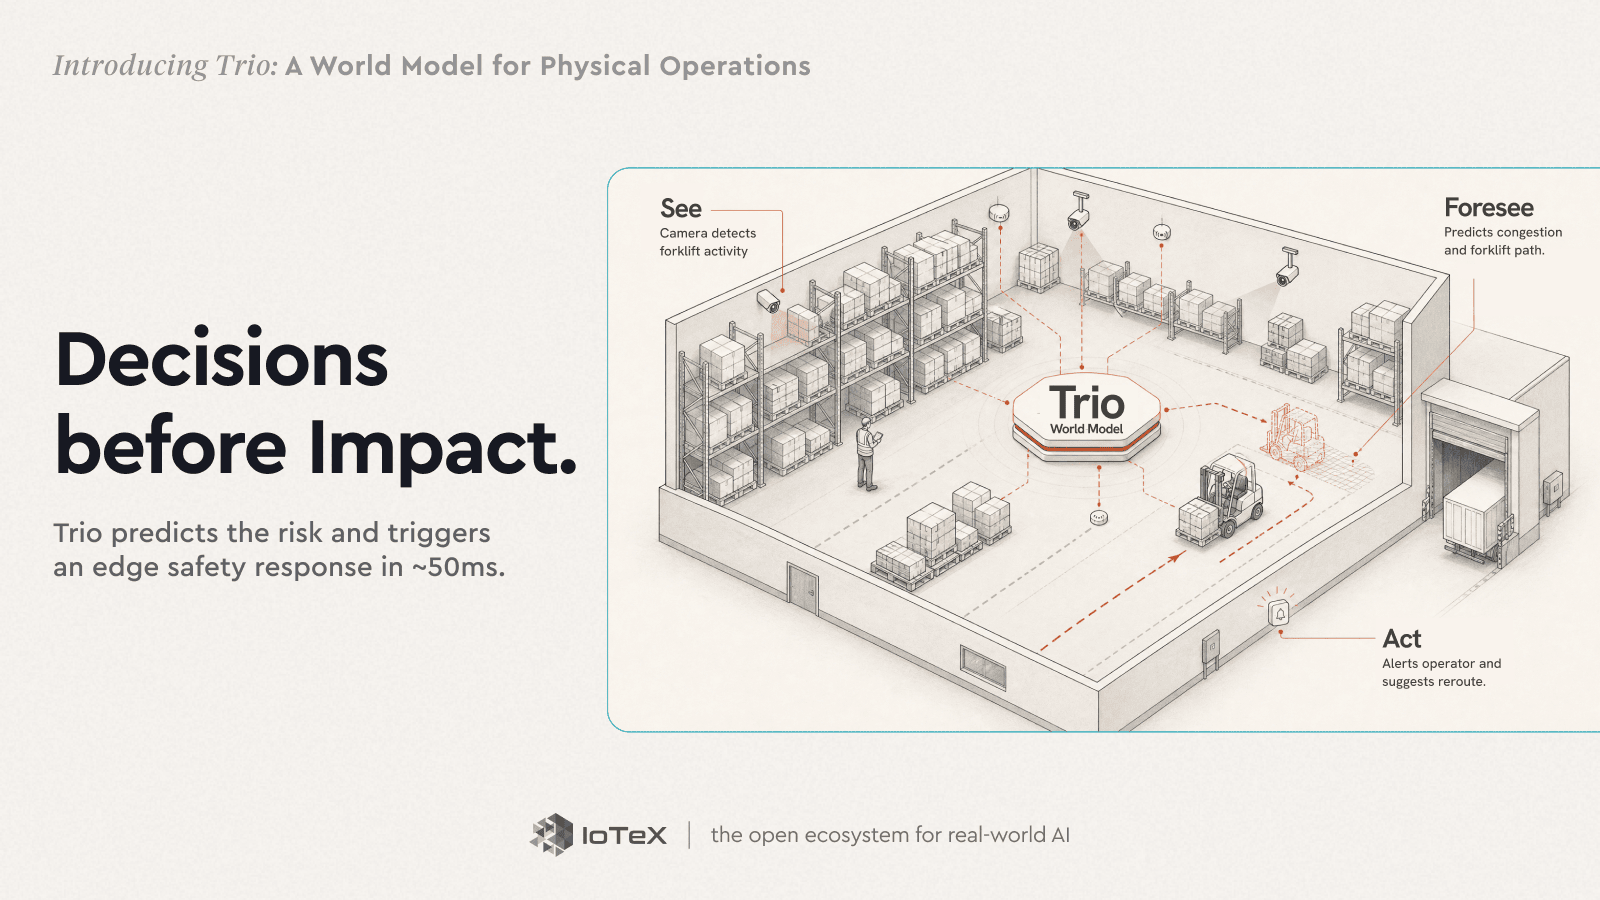
Lepaskan abstraksinya. Sebuah dermaga pemuatan, di tengah shift kerja. Sebuah forklift mundur keluar dari bay; seorang pekerja melangkah keluar dari antara dua rak pada jalur yang bersilangan dengannya. Keduanya belum bisa saling melihat.
Melihat — Trio-Retina, yang berjalan pada kotak kecil di samping kamera, sudah melacak keduanya sebagai objek: forklift dan orang tersebut, posisi mereka, dan ke arah mana masing-masing bergerak.
Memprediksi — model dunia milik Trio memproyeksikan dua detik ke depan. Kedua jalur tersebut bersilangan. Ia pernah melihat geometri persis seperti ini berakhir buruk sebelumnya.
Bertindak — sebuah gerbang keselamatan edge yang deterministik memicu alarm persilangan dalam waktu sekitar 50 milidetik — lebih cepat daripada waktu reaksi manusia mana pun — dan forklift diberi sinyal untuk berhenti. Hampir celaka, bukan laporan insiden.
Itulah keseluruhan tesisnya dalam satu frame: bukan rekaman yang Anda putar ulang setelah sesuatu terjadi, melainkan keputusan yang diambil sesaat sebelum itu terjadi.
Sebuah Model Dunia Nyata — dan Bagaimana Milik Kami Berbeda
Trio berada di dalam sebuah bidang yang bergerak cepat. Model dunia adalah tempat banyak pemikir terbaik AI kini mengarahkan perhatiannya. Gagasan ini bermula dari World Models (2018) karya Ha & Schmidhuber — sebuah agen yang mempelajari model kompak dari lingkungannya dan “bermimpi” simulasi di dalamnya. Yann LeCun berpendapat bahwa model dunia prediktif dalam ruang laten (JEPA miliknya) adalah potongan yang hilang di jalan menuju kecerdasan mesin otonom; Fei-Fei Li menyebut batas terdepan ini sebagai kecerdasan spasial, dan World Labs miliknya membangun model yang menghasilkan dunia 3D yang dapat dijelajahi. Bidang ini secara garis besar terbagi menjadi beberapa kubu:
- Prediksi laten — V-JEPA 2 (Meta) dan jajaran Dreamer mempelajari dinamika dalam ruang laten dan merencanakan di dalamnya.
- Dunia generatif & interaktif — Genie 3 (DeepMind), NVIDIA Cosmos, dan Marble dari World Labs membayangkan dan menghasilkan lingkungan.
- Mengemudi — Tesla FSD dan GAIA-2 milik Wayve menjalankan model dunia yang paling banyak digunakan di Bumi — untuk satu mobil.
- Robotika — Physical Intelligence, Skild AI, dan Figure membangun model fondasi untuk satu robot.
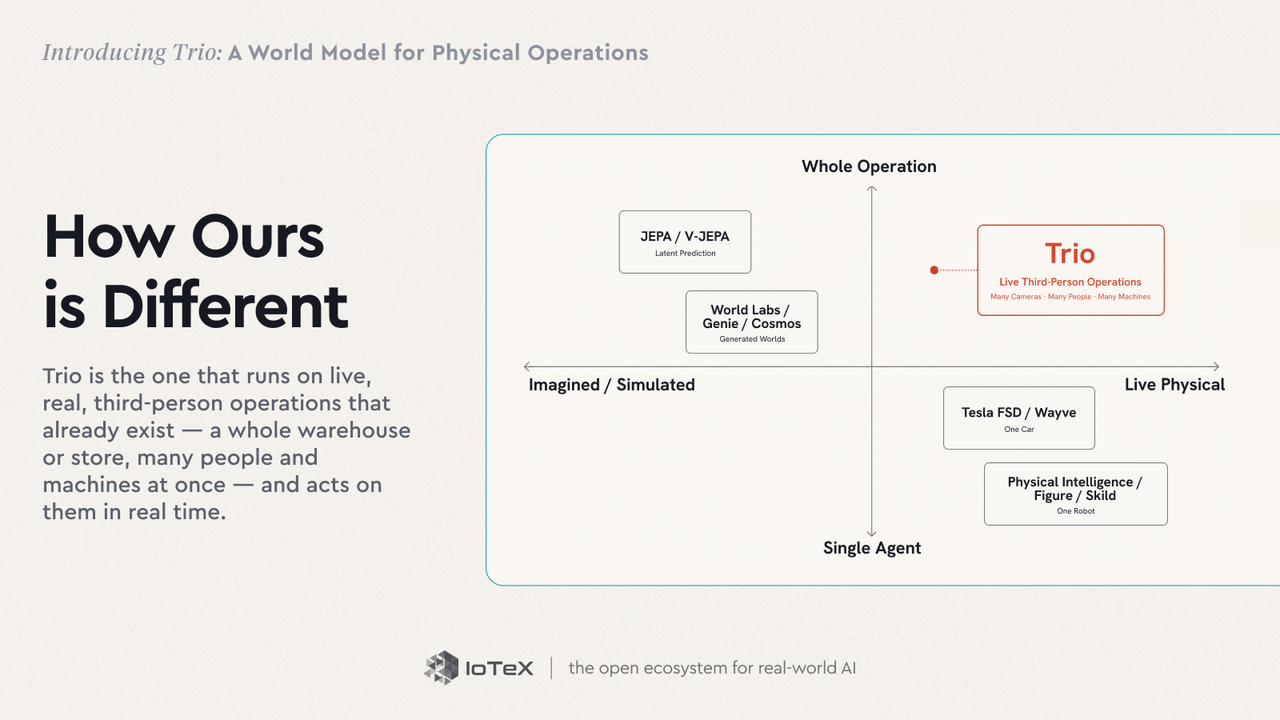
Hampir semuanya baik membayangkan atau mensimulasikan sebuah dunia, atau memodelkan domain egosentris dari satu agen — satu mobil, satu robot. Trio adalah yang berjalan pada operasi nyata, langsung, dan sudut pandang orang ketiga yang sudah ada — seluruh gudang atau toko, banyak orang dan mesin sekaligus — dan bertindak terhadapnya secara real time.
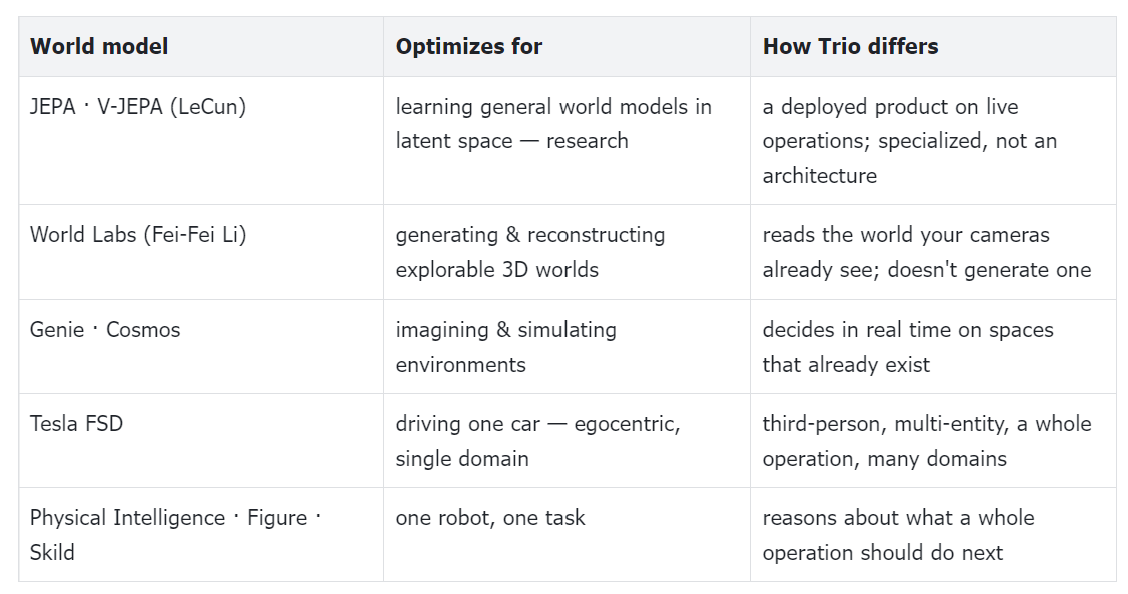
Dua sumbu yang membedakan Trio. Secara teknis — kecil, cepat, dan terspesialisasi: real-time di edge, batas bawah sekitar $0,004 per kueri, ditagih per keputusan, fondasi yang dibekukan ditambah adapter kecil per situs (LoRA, dilatih dalam GPU-hours) alih-alih satu model umum raksasa yang dijalankan ulang pada setiap frame. Pada benchmark streaming OVBench, membungkus model open-weights dalam stack Trio meningkatkan akurasi +2,3 poin murni dari arsitektur, dan persepsinya melakukan streaming tanpa batas menit tetap yang membatasi model-model terdepan. Berdasarkan skenario — Trio berjalan pada operasi-operasi yang sudah ada, dan bertindak atas operasi tersebut sekarang, alih-alih membayangkan sebuah dunia, mengemudikan satu mobil, atau menggerakkan satu robot.
Bagaimana Trio Dibangun
Untuk tim teknis: berikut cara Trio tetap cepat dan cukup murah untuk dijalankan pada setiap kamera, sepanjang hari. Jika Anda di sini untuk kisah operasionalnya, lewati bagian ini — intinya ada di baris terakhir.
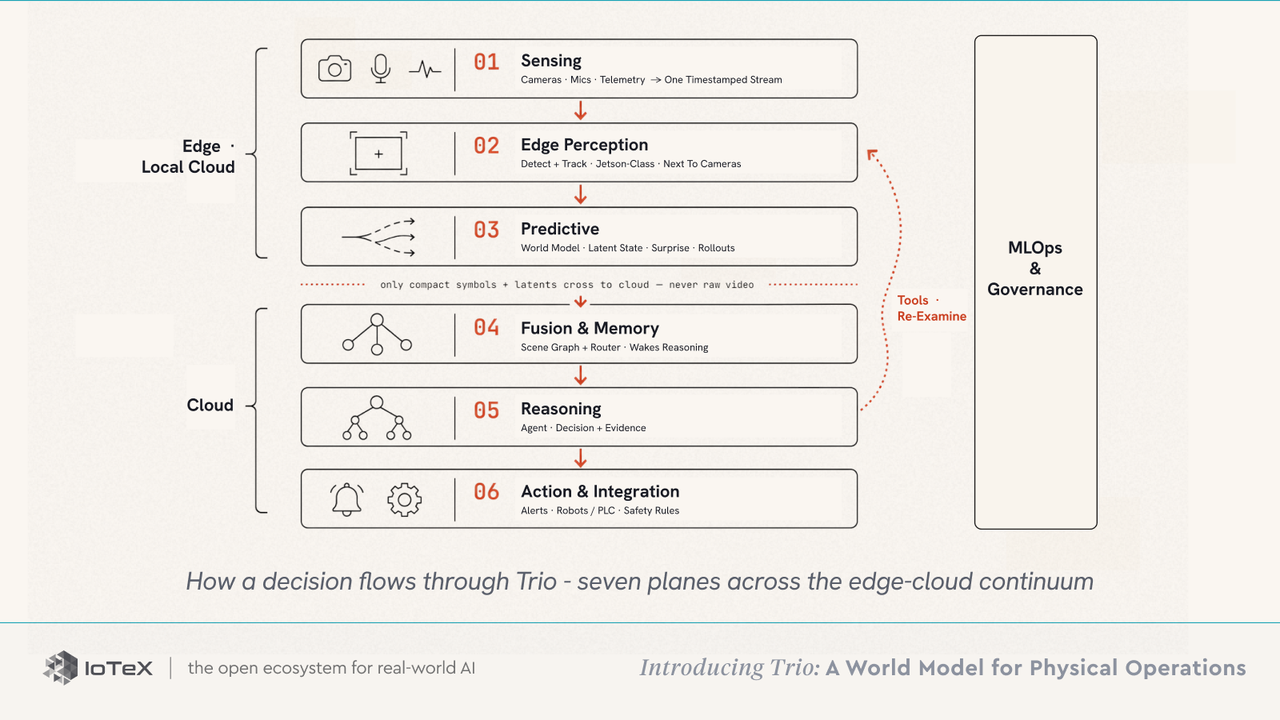
Lima prinsip menyatukan sistem ini: setiap antarmuka antar lapisan adalah scene graph yang strongly-typed dan dapat diperiksa (bukan vektor opak); sebuah router mengendalikan biaya, menjalankan lapisan-lapisan murah secara terus-menerus dan membangunkan penalaran yang mahal hanya saat diperlukan; alat-alat bersifat dua arah, sehingga lapisan penalaran dapat memerintahkan lapisan-lapisan bawah untuk memeriksa ulang atau mensimulasikan ulang; setiap keputusan disertai buktinya, sehingga operator dapat memeriksa, membantah, dan mengambil alih keputusan tersebut; dan model-model fondasi tetap dibekukan sementara adapter kecil per-penerapan — modul LoRA dan adapter fusi lintas-tingkat, dilatih dalam GPU-hours alih-alih pelatihan ulang penuh — menyesuaikan setiap situs.
Prinsip-prinsip tersebut diwujudkan sebagai tujuh lapisan (plane) — enam berada di jalur satu keputusan, ditambah tata kelola yang mencakup semuanya: Sensing (kamera · mikrofon · telemetri → satu aliran berstempel waktu) → Edge Perception (deteksi + pelacakan, kelas Jetson, tepat di samping kamera) → Predictive (world model: status laten · kejutan · rollout) → Fusion & Memory (scene graph + router yang membangunkan penalaran) → Reasoning (agen → keputusan yang dipasangkan dengan buktinya) → Action & Integration (peringatan · robot / PLC · aturan keselamatan independen), dengan MLOps & Governance yang mencakup semuanya.
Karena persepsi dan prediksi berjalan secara lokal dan hanya simbol serta laten yang ringkas yang dikirim ke cloud — bukan video mentah — Trio ditagih per keputusan, bukan per token per frame.
Di Mana Trio Berjalan
Gudang tersebut hanyalah satu bingkai. Restoran, tempat cuci mobil, toko, pabrik yang menjadi pembuka kita — model yang sama diarahkan ke operasi apa pun yang berjalan dengan kamera, saat ini berdampingan dengan operator manusia, menampilkan apa yang terlewat oleh sistem mereka yang sudah ada:
- Operasi Waralaba — Manajemen antrean, pengurangan penyusutan, kepatuhan karyawan, analitik alur pelanggan.
- Keamanan & Akses — Deteksi penyusupan, analisis loitering, pencegahan tailgating, penegakan aturan di luar jam kerja.
- Logistik & Pergudangan — Status dermaga, waktu tinggal kendaraan, kepatuhan APD, penegakan SOP keselamatan di seluruh halaman dan lantai.
- Manufaktur & Industri — Pemantauan lini, deteksi cacat, peringatan bahaya di setiap lini dan zona mesin.
- Kota Cerdas — Parkir, arus lalu lintas, keselamatan publik, pemantauan infrastruktur di jalan dan transit.
- Kesehatan & Ilmu Hayati — Deteksi jatuh, pola hunian, pemantauan perilaku di kamar penghuni dan area kampus.
- Perhotelan & Venue — Manajemen kerumunan, kontrol akses zona VIP, respons insiden real-time dalam skala besar.
- Infrastruktur Kritis — Intelijen perimeter 24/7, deteksi penyusupan, respons otonom untuk situs yang tidak boleh melewatkan satu pun peringatan.
Apa yang Telah Kami Bangun — dan Apa Selanjutnya
Trio bukan lagi sekadar tesis di papan tulis. Laporan teknis v1.0 memformalkan sistem secara utuh — stack persepsi–prediksi–aksi, lima prinsip, tujuh plane — dengan dua domain referensi yang dikerjakan secara penuh (tempat cuci mobil dan gudang), hingga insiden nyaris tabrakan forklift-dan-pejalan kaki di atas, yang ditangkap oleh deterministic edge safety gate yang bereaksi dalam sekitar 50 milidetik, jauh di bawah batas 100 ms. Trio-Retina bersifat open source (pip install trio-retina), dan Playground sudah aktif — buka dan saksikan Trio membaca rekaman nyata langsung di browser Anda.
Tiga kekuatan membuat saat ini menjadi momen yang tepat: silikon edge akhirnya dapat menjalankan penalaran operasional secara real-time tanpa perlu bolak-balik ke cloud; pemahaman adegan multi-entitas telah melewati ambang batas penelitian yang tidak pernah dicapai oleh deteksi objek tunggal; dan para operator lingkungan fisik sudah siap untuk apa yang mungkin merupakan kemampuan paling undervalued dalam AI saat ini — sebuah world model di atas kamera yang sudah mereka miliki, tanpa perangkat keras baru. Dari sini, Trio berkembang mengikuti alur — dari melihat dan memahami hari ini menuju meramalkan dan, pada waktunya, bertindak di lapangan.
Mulai dengan Trio hari ini
Dua cara untuk mulai — keduanya sudah aktif sekarang:
BANGUN DI ATASNYA · DEVELOPER — Trio-Retina di GitHub. Lapisan persepsi open-source — lapisan state yang model-agnostic yang mengubah detektor apa pun menjadi satu aliran standar berupa event plus latent state. pip install trio-retina dan jalankan di mesin Anda sendiri.
COBA LANGSUNG · OPERATOR — Trio-Lumen di platform. Lihat operasi Anda menjadi hidup di browser — Trio membaca rekaman nyata sebagai objek dengan state dan kerumunan sebagai aliran (flow), lalu arahkan ke kamera Anda sendiri dan tanyakan dalam bahasa yang sederhana.
Trio, IoTeX, dan Ekonomi Mesin
Trio tidak muncul begitu saja. Ia dibangun di atas satu dekade IoTeX — infrastruktur dan jaringan perangkat yang terhubung, identitas perangkat (ioID), data mesin yang dapat diverifikasi (Quicksilver), dan pembayaran mesin-ke-mesin (x402) yang dibutuhkan AI dunia nyata untuk mendarat di dunia nyata dengan data, identitas, dan kepercayaan di baliknya. Dan Trio adalah produk yang mewujudkan visi IoTeX secara konkret: Challenge 1 bertujuan menjadikan IoTeX sebagai antarmuka tempat AI melihat, memverifikasi, dan bertindak terhadap dunia fisik, dan Trio adalah bagian yang melihat itu.
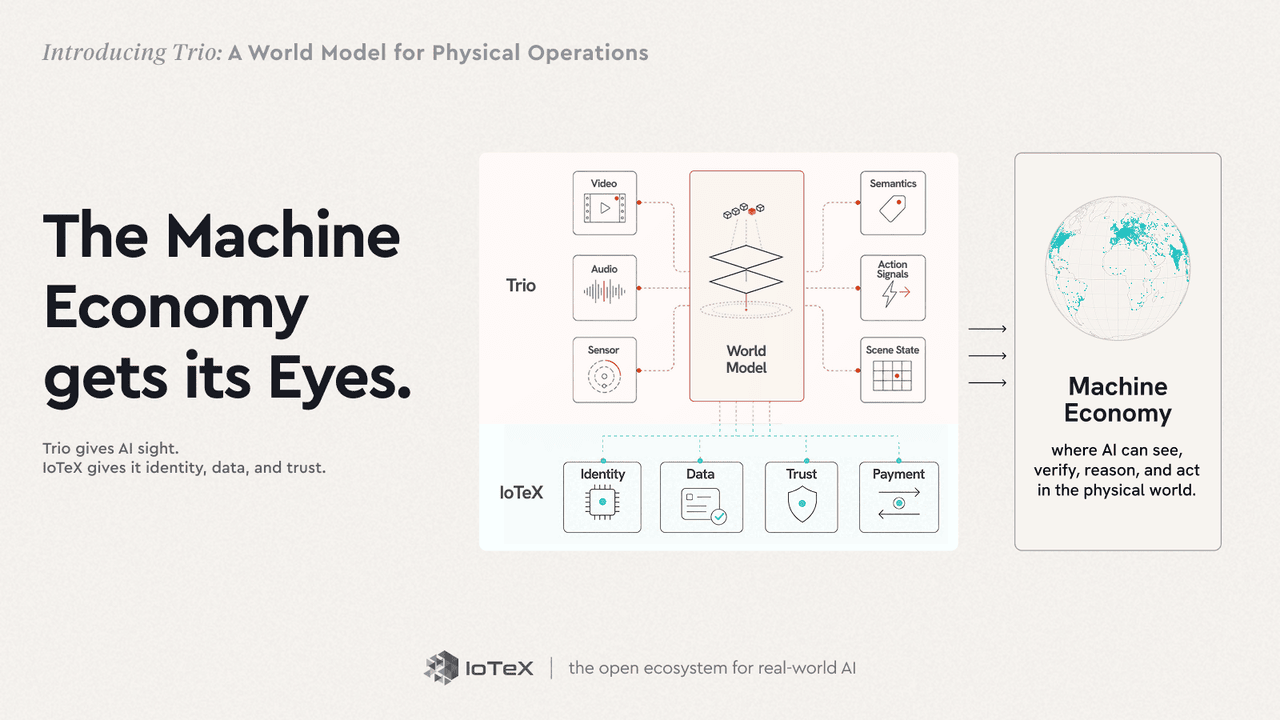
Gabungkan semuanya dan Anda mendapatkan ekonomi mesin yang dijelaskan dalam Anti-Roadmap. Mesin membutuhkan tiga hal: untuk melihat dunia, untuk mempercayai apa yang mereka lihat, dan untuk bertindak berdasarkan itu. IoTeX menyediakan kepercayaan yang terdesentralisasi, sementara Trio menyediakan mata dan telinga untuk mempersepsikan realitas fisik-dan otak untuk bernalar dan bertindak berdasarkan itu.
Terus Melangkah…
Challenge 1 kini memiliki jawaban. Memberi AI mata terhadap dunia fisik dan mewujudkannya — itulah tantangan pertama dan paling eksistensial dari Anti-Roadmap kami untuk 2026. Kami telah menemukan jalannya, dan kami terus membangun dengan kecepatan penuh sejak saat itu. Trio adalah AI dunia nyata yang benar-benar dirilis, bukan sekadar slideware — ia berjalan pada kamera yang sudah ada dan mengubahnya menjadi nilai sejak hari pertama.
Peluncuran resmi sudah dekat, dan masa depan yang kami janjikan hampir berada di tangan kita. Terima kasih telah membangun bersama kami dan terus ikuti perkembangannya.
— Tim IoTeX
Bacaan lebih lanjut tentang world model
- D. Ha, J. Schmidhuber. World Models. 2018.
- Y. LeCun. A Path Towards Autonomous Machine Intelligence. 2022. (memperkenalkan JEPA)
- F.-F. Li. From Words to Worlds: Spatial Intelligence is AI’s Next Frontier. 2025. (World Labs)
- D. Hafner, W. Yan, T. Lillicrap. Training Agents Inside of Scalable World Models (DreamerV4). 2025.
- Meta AI. V-JEPA 2. 2025.
- DeepMind. Genie 3. 2025.
- NVIDIA. Cosmos World Foundation Model Platform for Physical AI. 2025.
- Wayve. GAIA-2: a controllable multi-camera world model for driving. 2025.