
Trioのご紹介 — 物理オペレーションのためのワールドモデル

IoTeXの最新情報として、Trio、実世界向けAI、そしてAnti-Roadmapの最初の課題に対する私たちの答えをお届けします。
3月、IoTeXは2026年版Anti-Roadmapを公開しました——タイムラインではなく3つの課題です。課題1は存在をかけたもの:AIと物理世界とのインターフェースになることでした。私たちの答えは具体的でした——まずは視覚から。あらゆるライブ映像を、物理的な業務が実際にリアルタイムで行動に移せる知能へと変える。それがTrioです。IoTexのコアチームによってMachineFi Labで構築された、物理業務のための世界モデルです。私たちはこの課題を引き受け、今、それを世に送り出しています。
歴史上ずっと、物理世界は人によって動かされてきました。人が状況を見て、意味を判断し、行動する——トラックを運転し、ラインで作業し、現場を歩く。知覚し、予測し、行動する:このループには常に人間が必要でした。
AIはまずデジタル世界を変えました——言語、コード、画像。今、それが物理世界にも及び始めています。ライブの交通状況の中で車を運転するAI。ゲームのプレイ方法を、プレイを想像することで学習するAI。洗濯物の山をたたむロボット。これらすべての根底にあるもの——機械が状況を見て、次に何が起こるかを想像し、それに基づいて行動することを可能にするもの——それが世界モデルです。Trioは新しい種類の世界モデルです。業務全体をライブで見渡す「目」をAIに与えるものです。
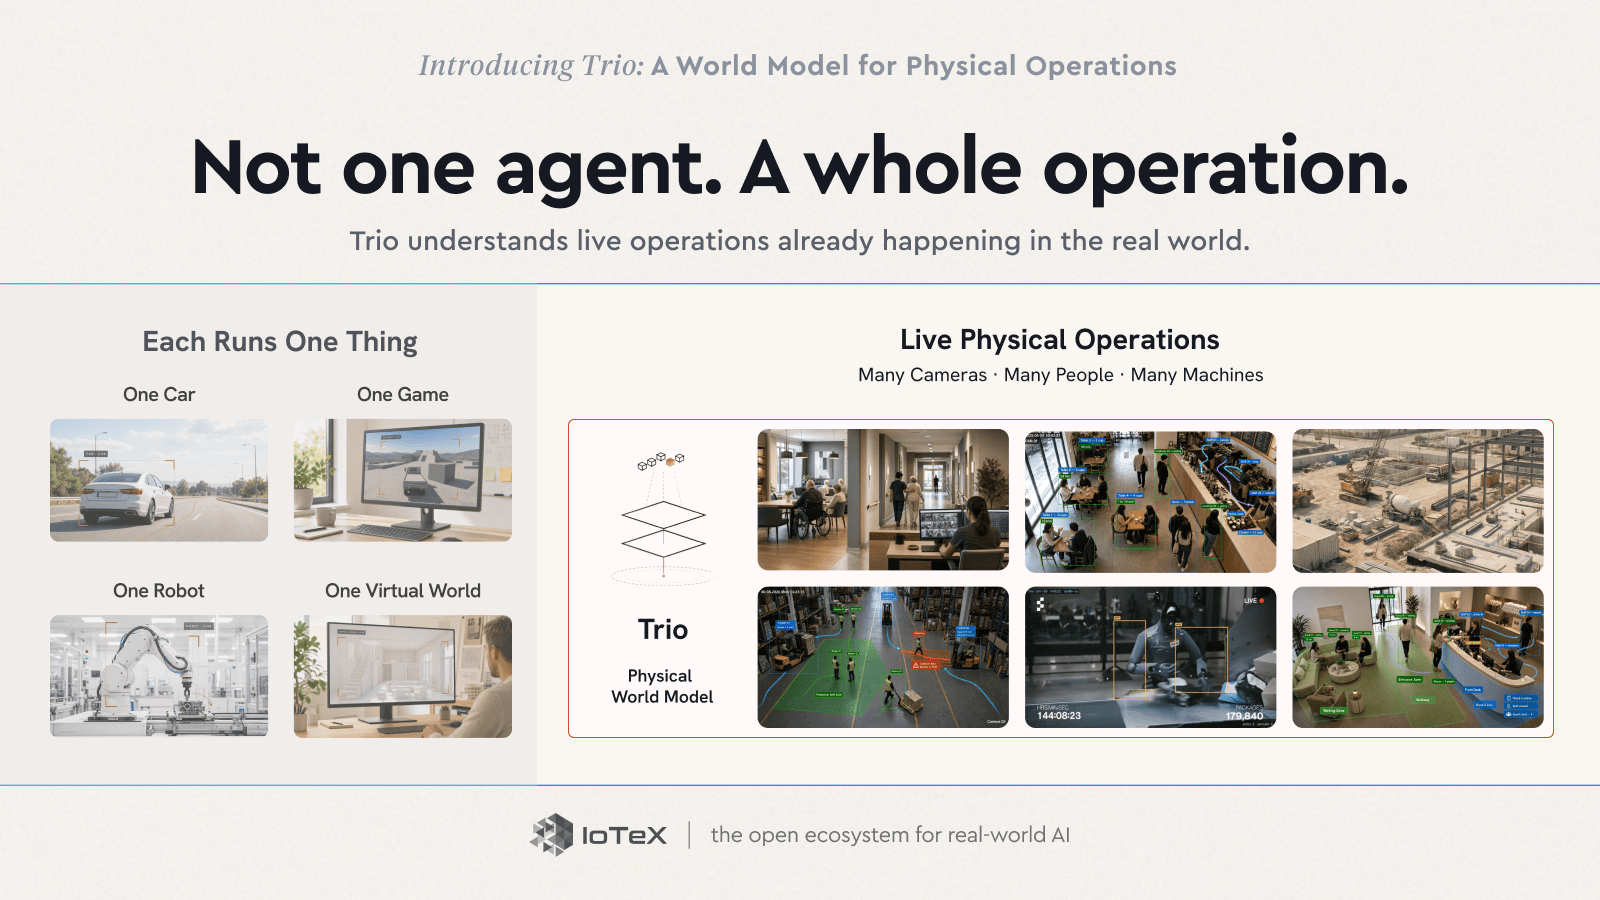
それら他の例は意図的に対象範囲が狭いものです:1台の車、1つのゲーム、1台のロボット、1つのタスク。しかし、最大の物理的な領域はすでに配線され、監視されています——あらゆる倉庫、店舗、工場、介護施設のフロアに設置されたカメラです……こうしたカメラの上で、業務全体をライブで動かす世界モデルこそが、課題1が求めていたインターフェースそのものです。それこそがTrioが作られた目的です。
Trioとは何か
これら4つの例に共通する点に注目してください:それぞれが1つのものを動かしています——1台の車、1つのゲーム、1台のロボット、1つの仮想世界。どれも業務(オペレーション)全体を動かしてはいません。そして、物理経済の大部分は実はそこにこそ存在しています——ランチのピーク時のレストラン、車を次々と洗浄ベイに通す洗車場、トラックへの積み込みを行う倉庫、フロアを稼働させる店舗、工場のライン——何十人もの人、車両、機械が同時に、昼夜を問わず動いている場所であり、そのすべてがカメラに映っているのに、誰も見る時間がありません。
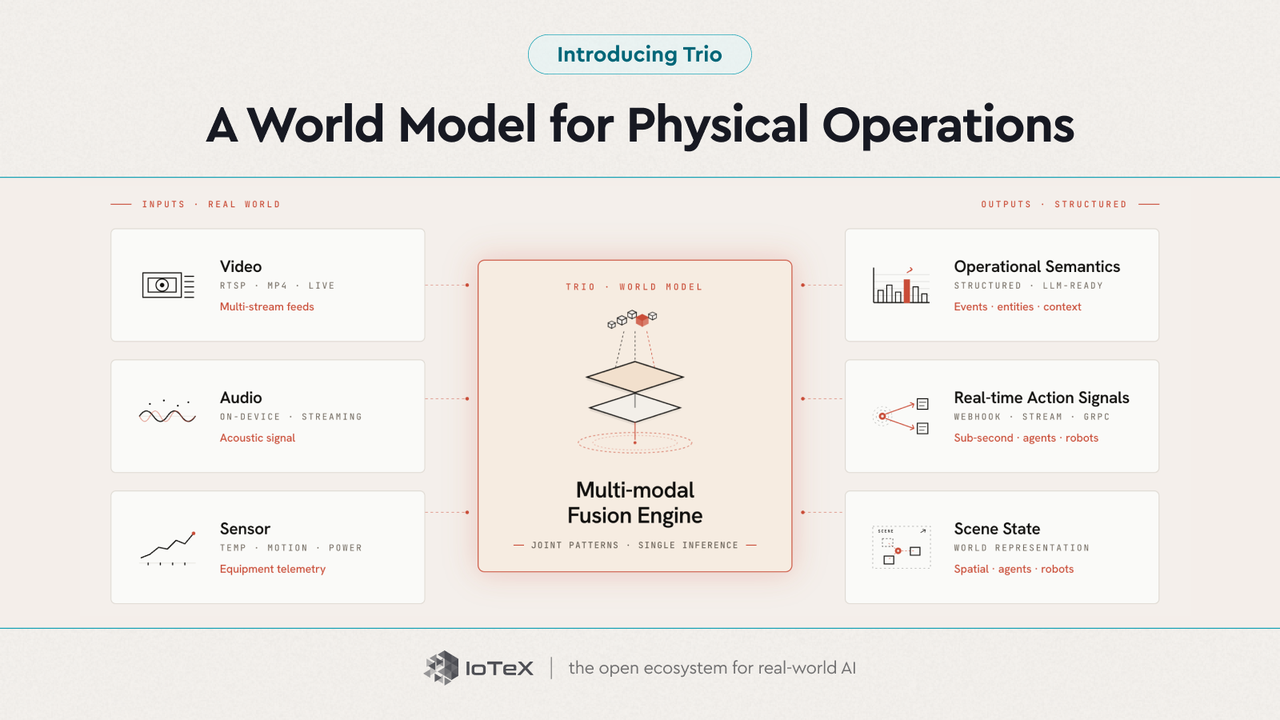
Trioはまさにそのために存在します。Trioは私たちの物理業務向け世界モデルです——単一の巨大なモデルではなく、ライブの業務を知覚し、予測し、行動に移すために連携して働く3つの製品からなるスイートです。言語モデルがテキストの仕組みを学ぶように、Trioはある場所の仕組みを学びます——そこに何があり、どう動き、次に何が起こるか——あなたの業務について、すでにお持ちのカメラやセンサーから学びます。私たちは言語モデルを置き換えるのではなく、それらに物理世界を与えるのです。
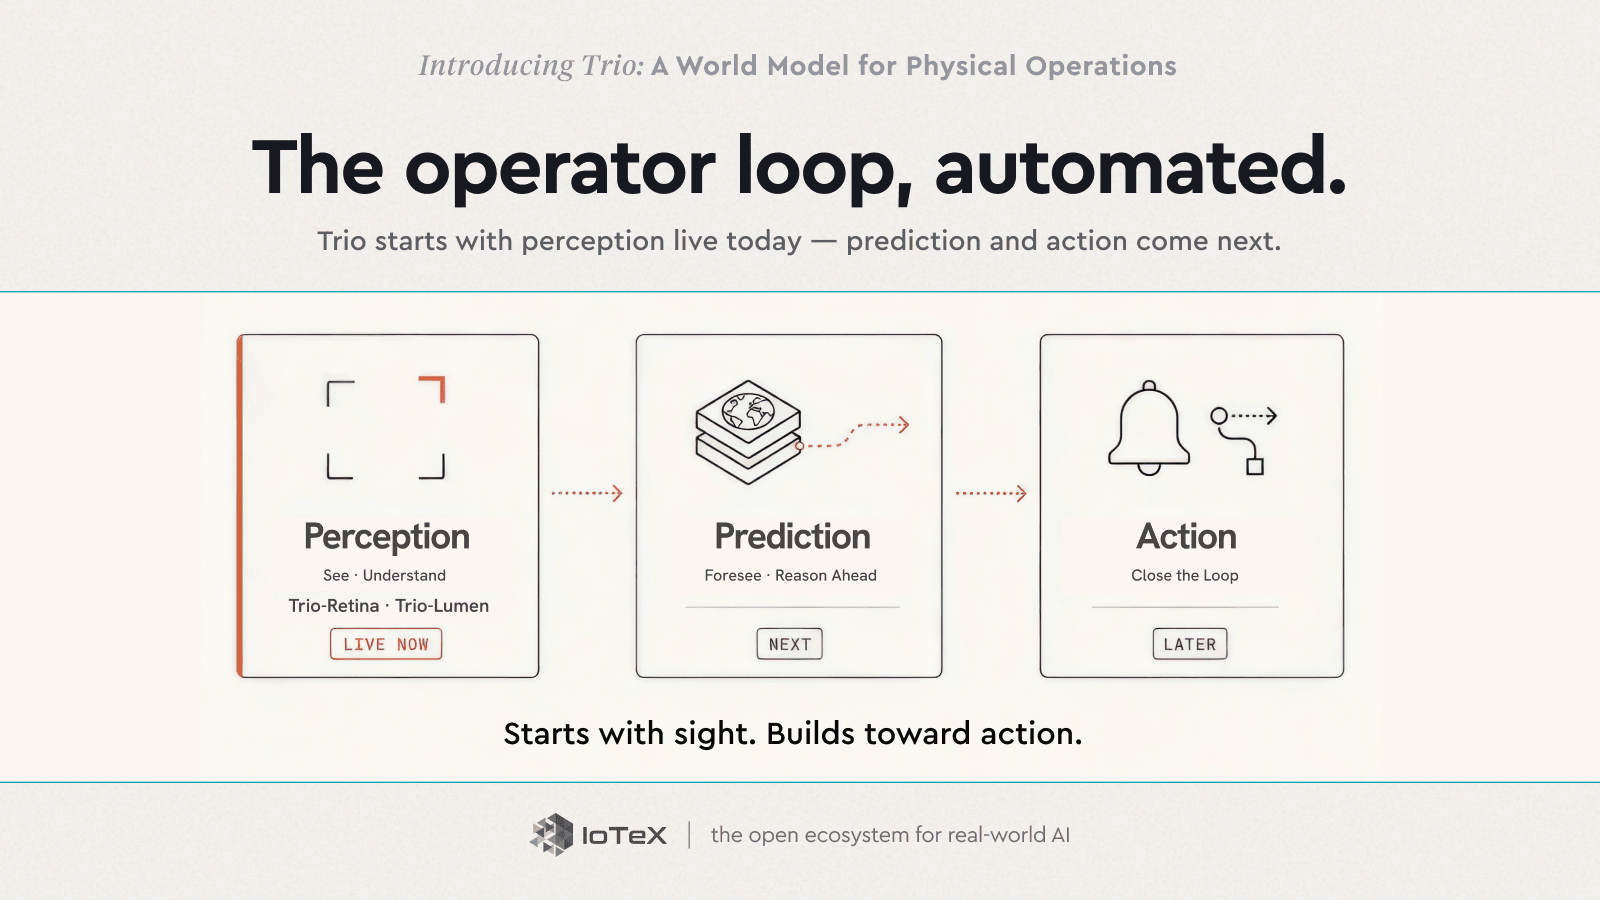
Trioはこのループを3つの段階で実行します——そして、その順序でリリースされます。知覚(Perception)は今日すでにライブで稼働しており、予測と行動はこれからです。
知覚 → 予測 → 行動
- 知覚 — 見る・理解する — Trio-Retina・Trio-Lumen — 現在稼働中
- 予測 — 先を見通し、先読みして推論する — 次のステップ
- 行動 — ループを閉じる — 今後
今日、そのうちの2つはすでに実現しており、あなたの手元にあります。 Trio-Retina(見る)は、あらゆるカメラ映像を、何が起きているかを示す1つの標準的なライブ情報へと変換します——誰がどこにいるか、何をしているか、どこへ向かっているか。Trio-Lumen(理解する)は、それを平易な英語でプログラム可能にします——「営業時間外に積み込み場にいる人物を検知する」——あらゆるフレームを昼夜問わず監視し、それをイベントとアラートに変換します。知覚と理解は、今日すでに提供されています。
pip install trio-retinaTrio-Retinaはオープンソースです。ご自身のマシンで実行することも、Playgroundでライブ体験することもできます。
この2つが、その先のすべての土台となります。予見と行動——問題が起きる前にそれを察知し、現場で行動を起こすこと——がループの次の段階です。この順序は意図的なものです。まだ見えていないものを予見することはできないため、私たちはまず「見る」機能を構築しました。
オープンなインターネット上で学習したモデルは、世界がどう見えるかを学びます。Trioは、あなたの現場がどう動いているかを学びます。
ある倉庫での実際の様子
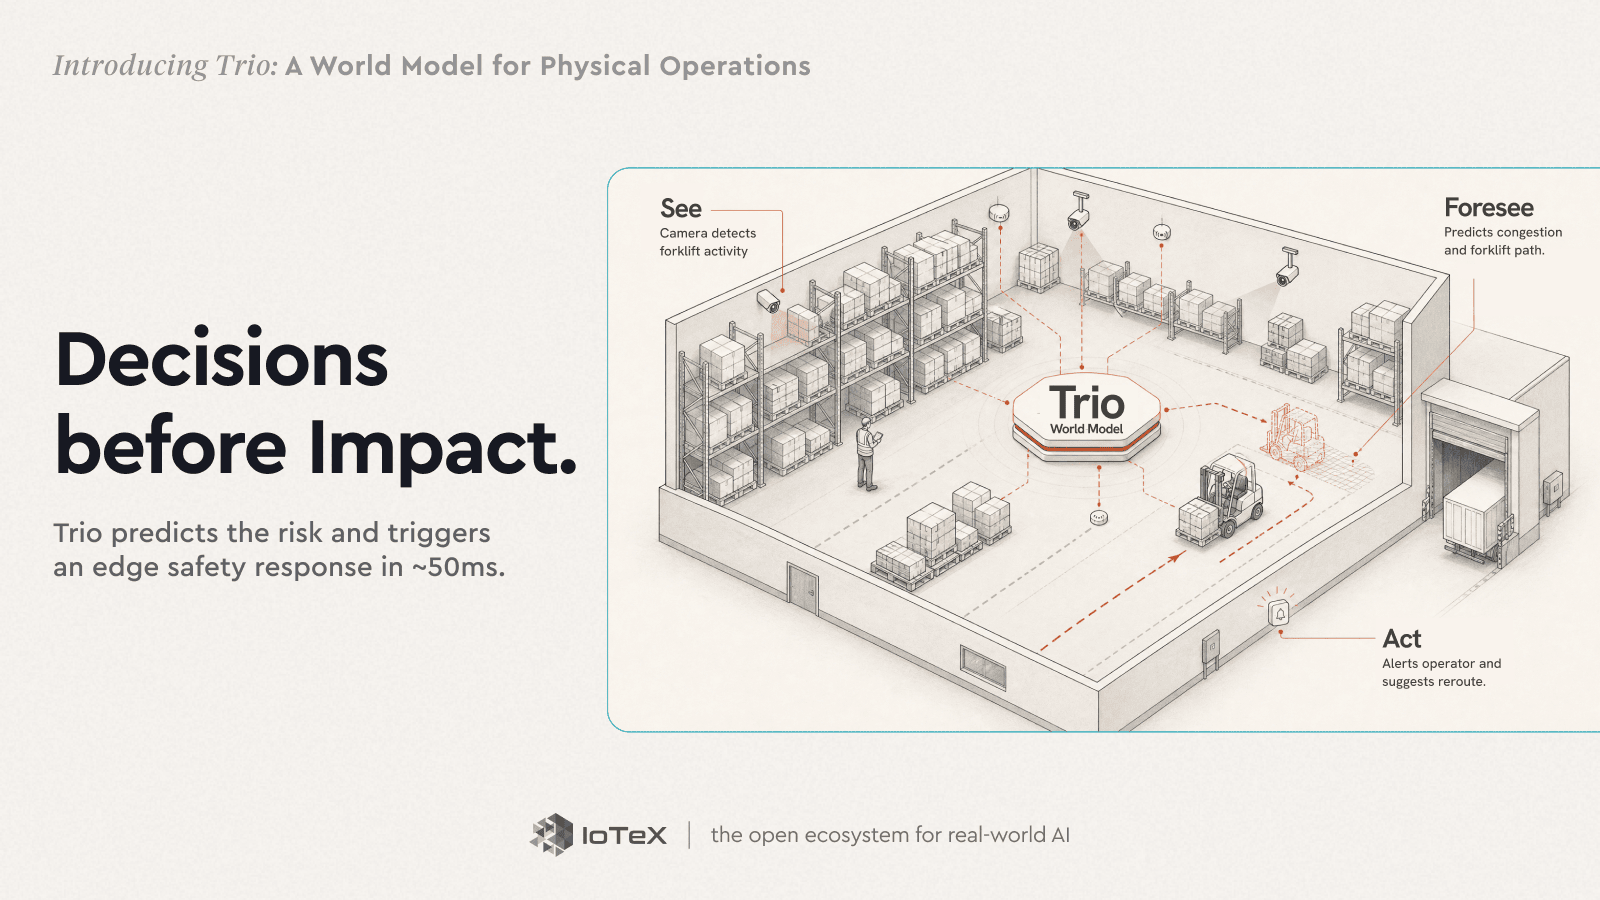
抽象論を取り除いてみましょう。シフトの最中、荷積みドックにて。フォークリフトがベイからバックで出てきます。作業員が2つのラックの間から、フォークリフトの進路を横切る形で出てきます。どちらもまだ相手に気づいていません。
See(見る) — カメラの隣にある小さなボックス上で稼働するTrio-Retinaは、すでにフォークリフトと人物の両方を追跡対象として捉え、それぞれの位置と進行方向を把握しています。
Foresee(予見する) — Trioのワールドモデルが、次の2秒間を先読みします。2つの経路が交差します。このまったく同じ配置が過去に悪い結果につながったことを、モデルはすでに「見て」います。
Act(行動する) — 決定論的なエッジ安全ゲートが、約50ミリ秒——人間の反応速度よりも速く——で交差警報を発し、フォークリフトには停止信号が送られます。事故報告書の代わりに、ヒヤリハットで済みます。
それが、このテーマ全体を一枚の場面に凝縮したものです。何かが起きた後に見返す映像ではなく、それが起きる直前に下される判断です。
本物のワールドモデル——そして私たちのモデルが違う理由
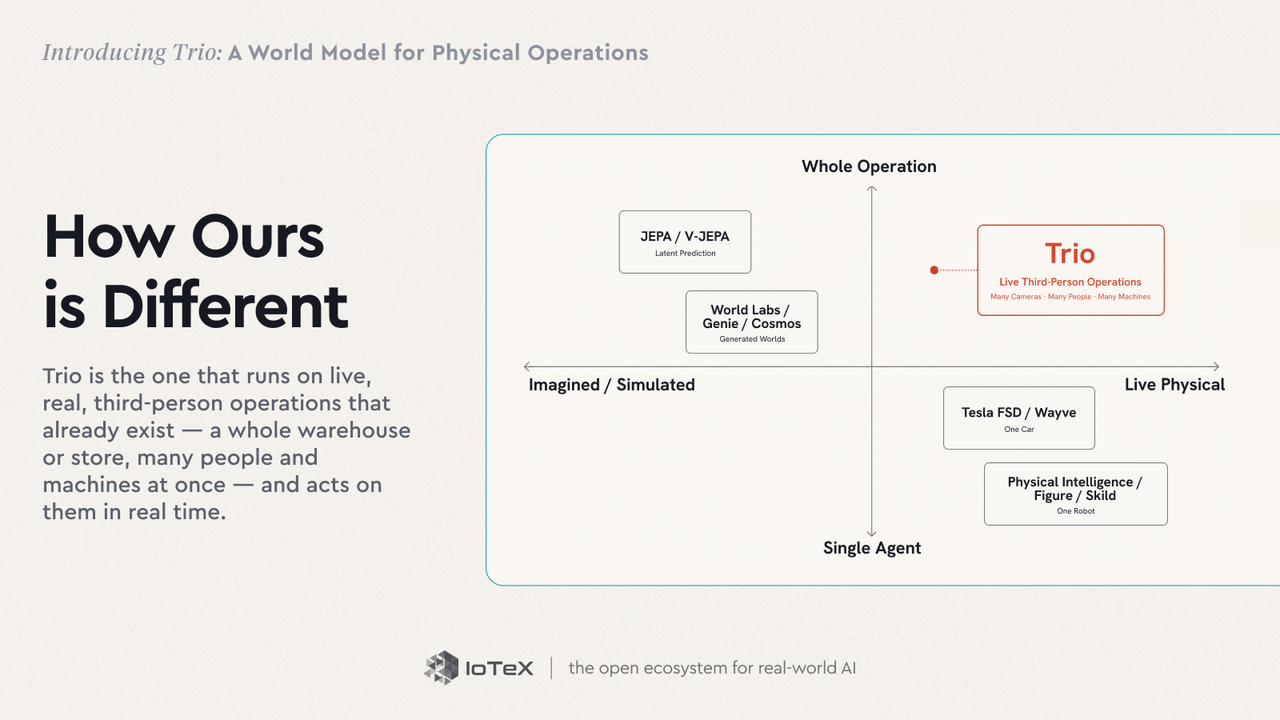
Trioは、目まぐるしく動く分野の中に位置しています。ワールドモデルは、今やAI界の優れた頭脳の多くが注目している領域です。このアイデアは、Ha & SchmidhuberのWorld Models(2018年)——エージェントが環境のコンパクトなモデルを学習し、その中で「夢を見る」ようにロールアウトするという発想——に端を発します。Yann LeCunは、潜在空間における予測的ワールドモデル(彼のJEPA)こそが、自律的な機械知能への道に欠けているピースだと主張しています。Fei-Fei Liはそのフロンティアを空間知能と呼び、彼女のWorld Labsは探索可能な3次元世界を生成するモデルを構築しています。この分野は、おおよそ次のような陣営に分かれています。
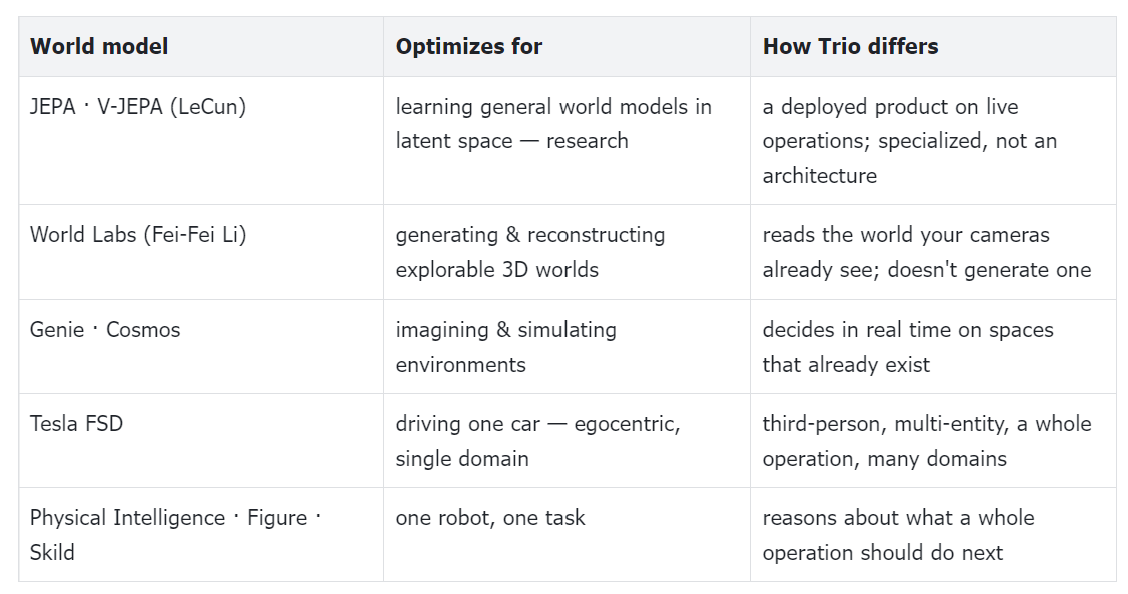
- 潜在空間予測 — V-JEPA 2(Meta)やDreamer系列は、潜在空間でダイナミクスを学習し、その中で計画を立てます。
- 生成的・対話的な世界 — Genie 3(DeepMind)、NVIDIA Cosmos、World LabsのMarbleは、環境を想像し生成します。
- 自動運転 — Tesla FSDとWayveのGAIA-2は、地球上で最も多く展開されているワールドモデルを——1台の車のために——稼働させています。
- ロボティクス — Physical Intelligence、Skild AI、Figureは、単一のロボットのための基盤モデルを構築しています。
そのほぼすべてが、世界を想像またはシミュレートするか、あるいは単一のエージェントの自己中心的な領域——1台の車、1台のロボット——をモデル化しています。Trioは、すでに存在するライブで実際の、第三者視点の現場業務——倉庫や店舗全体、同時に多くの人と機械が動く現場——で稼働し、それに対してリアルタイムに行動を起こす唯一の存在です。
Trioを際立たせる軸は2つあります。技術面では、小さく、速く、専門特化しています。エッジでのリアルタイム処理、クエリあたり0.004ドルという下限価格、判断ごとの課金、そして毎フレームで巨大な汎用モデルを再実行するのではなく、凍結された基盤モデルにサイトごとの小さなアダプター(LoRA、GPU時間単位で学習)を組み合わせる方式です。OVBenchストリーミングベンチマークでは、オープンウェイトモデルをTrioのスタックでラップするだけで、アーキテクチャの効果だけで精度が+2.3ポイント向上し、そのパーセプションはフロンティアモデルが上限とする固定の分単位の制限なしにストリーミングされます。シナリオ面では、既存のオペレーションの上で動作し、ある世界を想像したり、1台の車を運転したり、1台のロボットを動かしたりするのではなく、今すぐそれらに対して行動します。
Trioはどのように構築されているか
技術チーム向け:Trioがすべてのカメラで一日中動作できるほど高速かつ低コストである理由をここで説明します。オペレーションの話に興味がある方は読み飛ばしてください——結論は最後の一文にあります。
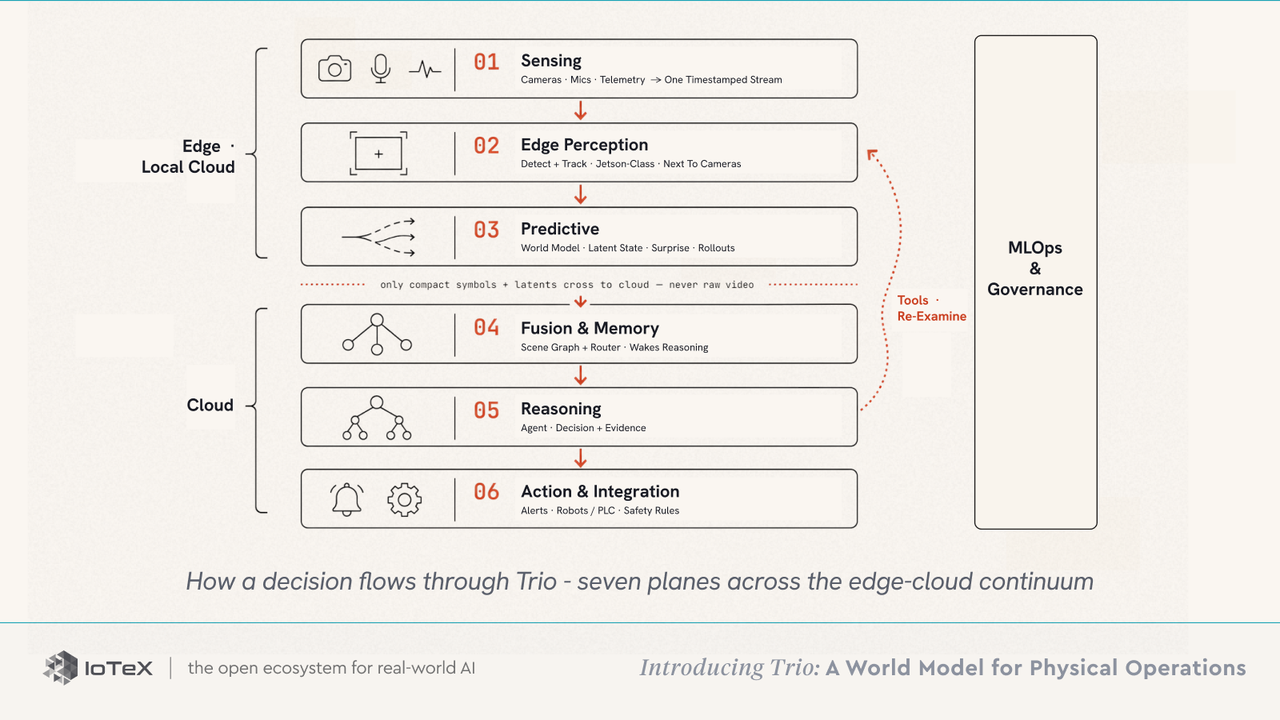
5つの原則がこのシステムを支えています。レイヤー間のすべてのインターフェースは強く型付けされ検査可能なシーングラフであり(決して不透明なベクトルではありません)、ルーターがコストを管理し、安価なレイヤーを常時稼働させながら必要なときだけ高価な推論を起動します。ツールは双方向であり、推論レイヤーが下位レイヤーに再検査や再シミュレーションを命令できます。すべての判断はその根拠とともに出力されるため、オペレーターは検査、異議申し立て、上書きが可能です。そして基盤モデルは凍結されたままで、サイトごとの小さなアダプター——LoRAモジュールとクロス階層融合アダプター、完全な再学習ではなくGPU時間単位で学習される——が各サイトに特化します。
これらの原則は7つのプレーンとして実現されています——1つの判断の経路上に6つ、それに加えてすべてを横断するガバナンスです。センシング(カメラ・マイク・テレメトリ→1つのタイムスタンプ付きストリーム)→エッジパーセプション(検出+追跡、Jetsonクラス、カメラのすぐそば)→予測(世界モデル:潜在状態・サプライズ・ロールアウト)→融合とメモリ(シーングラフ+推論を起動するルーター)→推論(エージェント→根拠と対になった判断)→アクションと統合(アラート・ロボット/PLC・独立した安全ルール)、そしてこれらすべてを横断するMLOpsとガバナンスです。
パーセプションと予測はローカルで実行され、クラウドに送られるのはコンパクトなシンボルと潜在表現のみ——生の映像は決して送られません——だからこそ、Trioはフレームごとのトークン課金ではなく、判断ごとに課金されます。
Trioはどこで動くのか
倉庫は1つの事例に過ぎません。レストラン、洗車場、店舗、そして私たちが最初に取り上げた工場——同じモデルが、カメラで運用されるあらゆるオペレーションに対応し、今日も人間のオペレーターと並んで、既存システムが見逃しているものを浮かび上がらせています。
- フランチャイズ運営——待ち行列管理、万引き・目減り削減、従業員コンプライアンス、顧客動線分析。
- セキュリティとアクセス管理——侵入検知、うろつき分析、テールゲート(共連れ)防止、時間外の取り締まり。
- ロジスティクスと倉庫管理——ドックの状態、車両の滞留時間、PPE(保護具)遵守、ヤードとフロア全体での安全SOPの徹底。
- 製造業・産業分野——ライン監視、不良品検出、すべてのラインと機械ゾーンにわたる危険アラート。
- スマートシティ——駐車、交通流、公共安全、道路と交通機関全体でのインフラ監視。
- ヘルスケア・ライフサイエンス——転倒検知、居室占有パターン、入居者の居室やキャンパス全体での行動モニタリング。
- ホスピタリティ・会場運営——群衆管理、VIPゾーンのアクセス制御、大規模なリアルタイムインシデント対応。
- 重要インフラ——24時間365日の境界監視、侵入検知、アラートを見逃せない施設のための自律対応。
これまでに構築したもの——そしてこれから
Trioはもはやホワイトボード上の理論ではありません。v1.0技術レポートは、パーセプション・予測・アクションのスタック、5つの原則、7つのプレーンという全体システムを、完全に検証された2つのリファレンスドメイン(洗車場と倉庫)とともに正式にまとめています。上述のフォークリフトと歩行者のニアミスも、決定論的なエッジ安全ゲートによって約50ミリ秒——100ミリ秒という上限に十分収まる速さ——で検知されたものです。Trio-Retinaはオープンソースとして公開されており(pip install trio-retina)、Playgroundも公開中です——開けば、ブラウザ上でTrioが実際の映像を読み解く様子をご覧いただけます。
今この瞬間が重要である理由は3つの力による。エッジ半導体がついにクラウドとの往復通信なしにリアルタイムの運用推論を実行できるようになったこと。複数エンティティのシーン理解が、単一物体検出では到達しえなかった研究上の閾値を超えたこと。そして、物理的な環境の運用者たちが、今日のAIにおいて最も過小評価されている能力かもしれないもの——すでに保有しているカメラの上に、新たなハードウェアなしでワールドモデルを構築すること——を受け入れる準備ができていること。ここからTrioはループを成長させていく——今日の「見る」「理解する」から、やがては「予見する」、そして時とともに現場で「行動する」へと。
今日からTrioを始める
参加方法は2つ——どちらも今すぐ利用可能です。
構築する · 開発者向け — GitHub上のTrio-Retina。 オープンソースの知覚レイヤー——モデルに依存しない状態レイヤーで、あらゆる検出器を標準化されたイベントストリームと潜在状態に変換します。pip install trio-retinaを実行し、自分のマシンで動かしてみましょう。
試してみる · 運用者向け — プラットフォーム上のTrio-Lumen。 自分の運用現場がブラウザ上で生き生きと動き出す様子をご覧ください——Trioが実際の映像を、状態を持つ物体や流れとしての群衆として読み取ります。そして、自分自身のカメラに向けて、平易な英語で質問することができます。
Trio、IoTeX、そしてマシンエコノミー
Trioは何もないところから生まれたわけではありません。IoTeXの10年間の蓄積——インフラとコネクテッドデバイスネットワーク、デバイスID(ioID)、検証可能なマシンデータ(Quicksilver)、そして機械同士の決済(x402)——の上に築かれています。これらはすべて、現実世界のAIがデータ、アイデンティティ、そして信頼を伴ってこの世界に着地するために必要なものです。そしてTrioは、IoTeXのビジョンを具体化するためのプロダクトです。Challenge 1は、IoTeXをAIが物理世界を見て、検証し、行動するためのインターフェースにすることを目指しており、Trioはその「見る」部分を担っています。
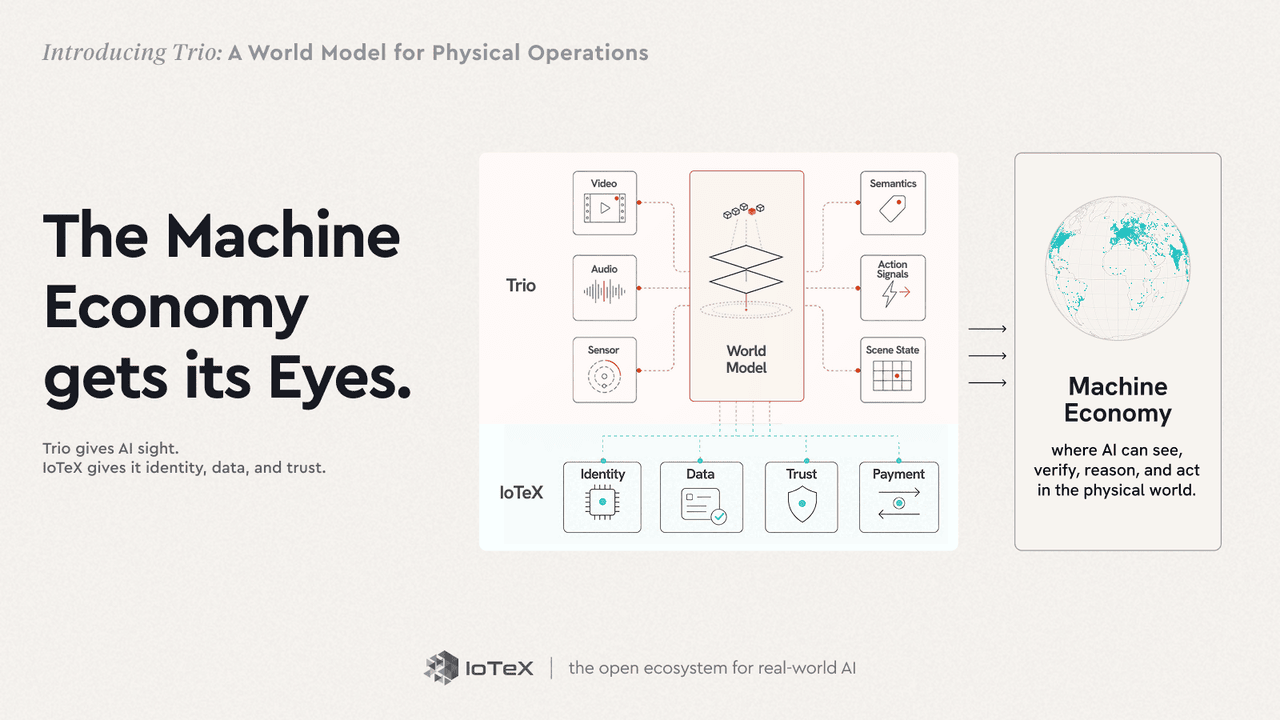
これらを組み合わせると、アンチロードマップが描いたマシンエコノミーが姿を現します。機械には3つのことが必要です——世界を見ること、見たものを信頼すること、そしてそれに基づいて行動することです。IoTeXは分散型の信頼を提供し、Trioは物理的な現実を知覚するための目と耳、そしてそれについて推論し行動するための頭脳を提供します。
出荷を続ける…
Challenge 1にはすでに答えがあります。AIに物理世界を見る目を与え、それを現実のものにする——それが私たちの2026年アンチロードマップにおける最初の、そして最も存立に関わる課題でした。私たちはその道筋を見つけ、それ以来全速力で構築を続けてきました。Trioはスライド資料ではなく、実際に出荷される現実世界のAIです——すでに設置されているカメラの上で動作し、初日から価値へと変えていきます。
正式なローンチは間近に迫っており、私たちが約束した未来はもうすぐ手の届くところにあります。私たちとともに構築し、注目し続けてくださったことに感謝します。
— IoTeXチーム
ワールドモデルに関するさらなる参考文献
- D. Ha, J. Schmidhuber. World Models. 2018年。
- Y. LeCun. A Path Towards Autonomous Machine Intelligence. 2022年。(JEPAを紹介)
- F.-F. Li. From Words to Worlds: Spatial Intelligence is AI’s Next Frontier. 2025年。(World Labs)
- D. Hafner, W. Yan, T. Lillicrap. Training Agents Inside of Scalable World Models (DreamerV4). 2025年。
- Meta AI. V-JEPA 2. 2025年。
- DeepMind. Genie 3. 2025年。
- NVIDIA. Cosmos World Foundation Model Platform for Physical AI. 2025年。
- Wayve. GAIA-2: a controllable multi-camera world model for driving. 2025年。