
Giới thiệu Trio — Mô hình thế giới cho các hoạt động vật lý

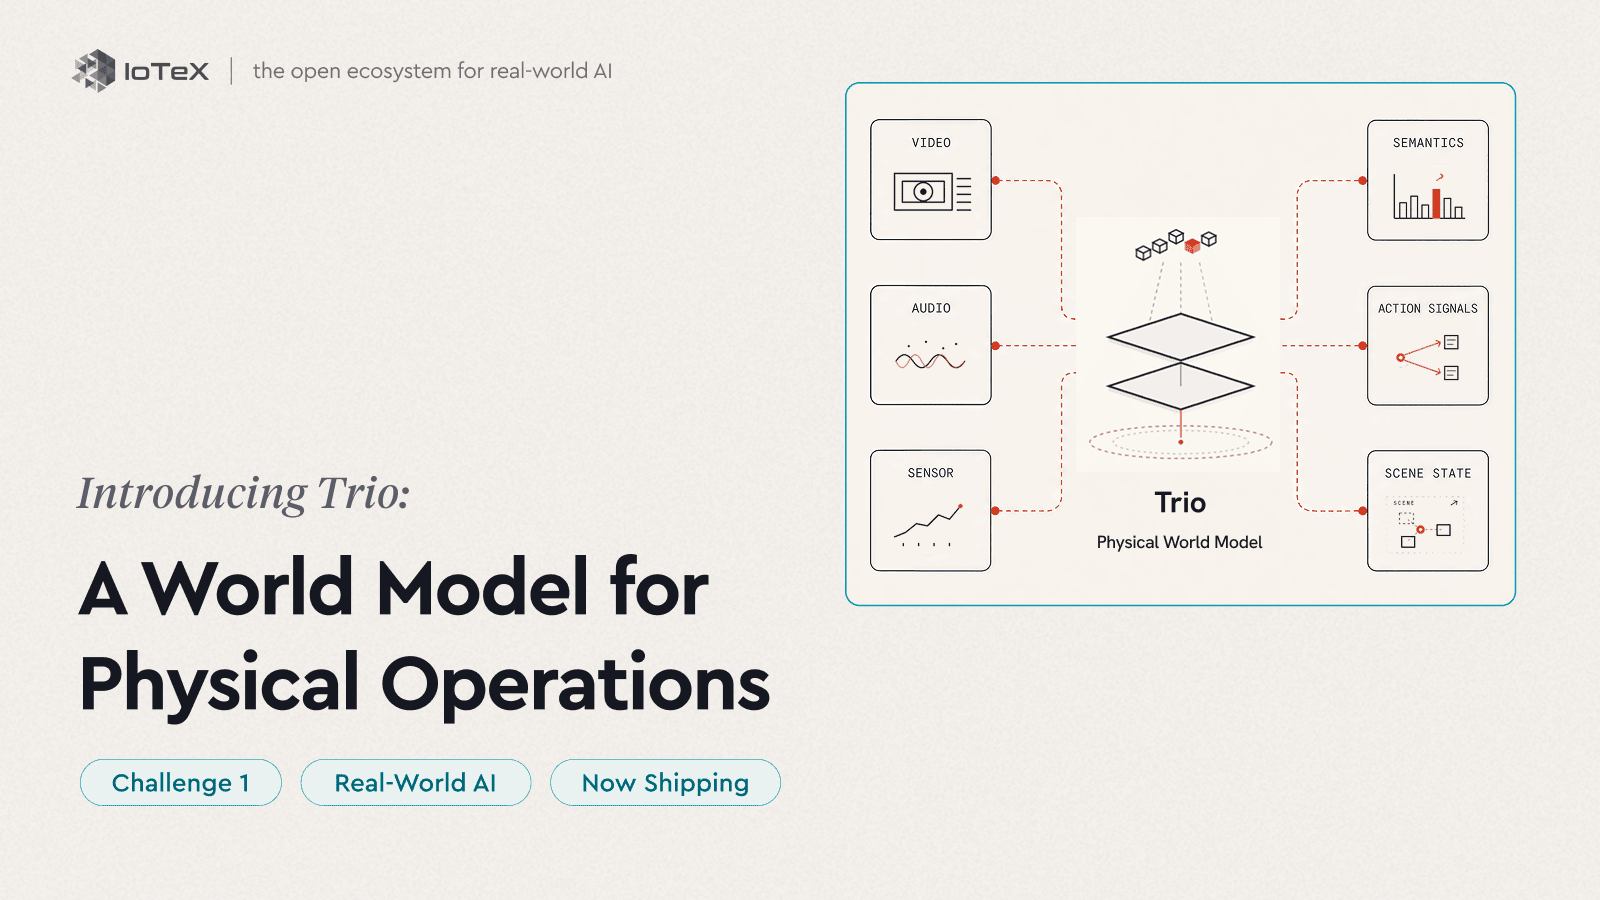
Cập nhật tình hình IoTeX về Trio, AI trong thế giới thực, và câu trả lời của chúng tôi cho thử thách đầu tiên của Anti-Roadmap.
Vào tháng 3, IoTeX đã công bố Anti-Roadmap cho năm 2026 — ba thử thách thay vì một lộ trình. Thử thách 1 là thử thách mang tính sống còn: trở thành giao diện của AI với thế giới vật lý. Câu trả lời của chúng tôi rất cụ thể — thị giác trước tiên, biến bất kỳ luồng phát trực tiếp nào thành trí tuệ mà bạn có thể hành động ngay trong các hoạt động vật lý theo thời gian thực. Câu trả lời đó chính là Trio, một mô hình thế giới (world model) cho các hoạt động vật lý, được xây dựng tại MachineFi Lab bởi đội ngũ cốt lõi đứng sau IoTeX. Chúng tôi đã nhận thử thách, và giờ đây chúng tôi đang triển khai nó.
Trong suốt lịch sử, thế giới vật lý luôn được vận hành bởi con người. Một người quan sát những gì đang diễn ra, đánh giá ý nghĩa của nó, và hành động dựa trên đó — lái xe tải, làm việc trên dây chuyền, đi khắp nhà xưởng. Nhận thức, dự đoán, hành động: vòng lặp đó luôn cần có con người trong đó.
AI đã thay đổi thế giới số trước tiên — ngôn ngữ, mã lập trình, hình ảnh. Giờ đây nó đang bắt đầu với thế giới vật lý. Một AI lái xe qua dòng giao thông thực. Một AI học cách chơi một trò chơi điện tử bằng cách hình dung cách nó vận hành. Một robot gấp một chồng quần áo. Phần cốt lõi bên dưới tất cả những điều đó — thứ cho phép một cỗ máy quan sát một tình huống, hình dung điều gì sẽ xảy ra tiếp theo, và hành động dựa trên đó — chính là một mô hình thế giới (world model). Trio là một loại mô hình thế giới mới: loại mang lại cho AI đôi mắt quan sát toàn bộ một hoạt động, theo thời gian thực.
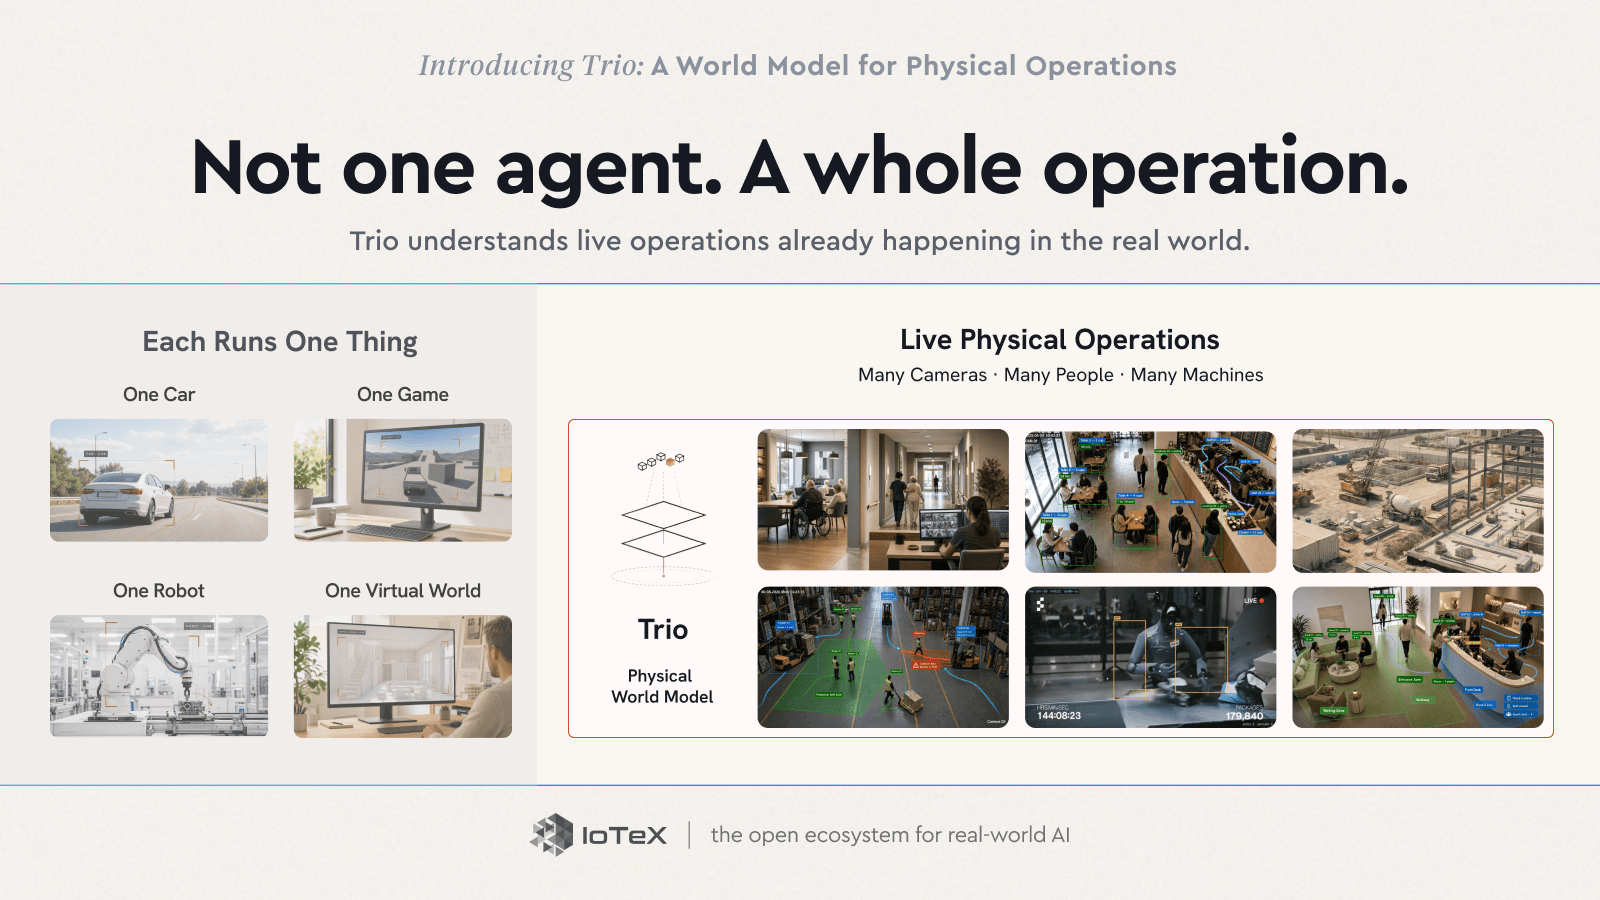
Những ví dụ khác đó có phạm vi hẹp một cách có chủ đích: một chiếc xe, một trò chơi, một robot, một tác vụ. Nhưng bề mặt vật lý lớn nhất lại đã được kết nối và giám sát sẵn — những chiếc camera trên mọi kho hàng, cửa hàng, nhà máy, và khu vực chăm sóc… Một mô hình thế giới hoạt động trên những camera đó — trên toàn bộ hoạt động, theo thời gian thực — chính là giao diện mà Thử thách 1 yêu cầu. Đó là những gì Trio được xây dựng để thực hiện.
Trio là gì
Hãy chú ý điểm chung của bốn ví dụ đó: mỗi ví dụ chỉ vận hành một thứ — một chiếc xe, một trò chơi, một robot, một thế giới ảo. Không cái nào trong số đó vận hành một hoạt động (operation). Và đó chính là nơi phần lớn nền kinh tế vật lý thực sự tồn tại — một nhà hàng vào giờ cao điểm bữa trưa, một trạm rửa xe luân chuyển xe qua các khoang rửa, một kho hàng bốc dỡ xe tải, một cửa hàng vận hành sàn bán hàng, một dây chuyền nhà máy — những nơi có hàng chục người, phương tiện, và máy móc di chuyển cùng lúc, suốt ngày đêm, tất cả đều được camera ghi lại nhưng không ai có thời gian để theo dõi.
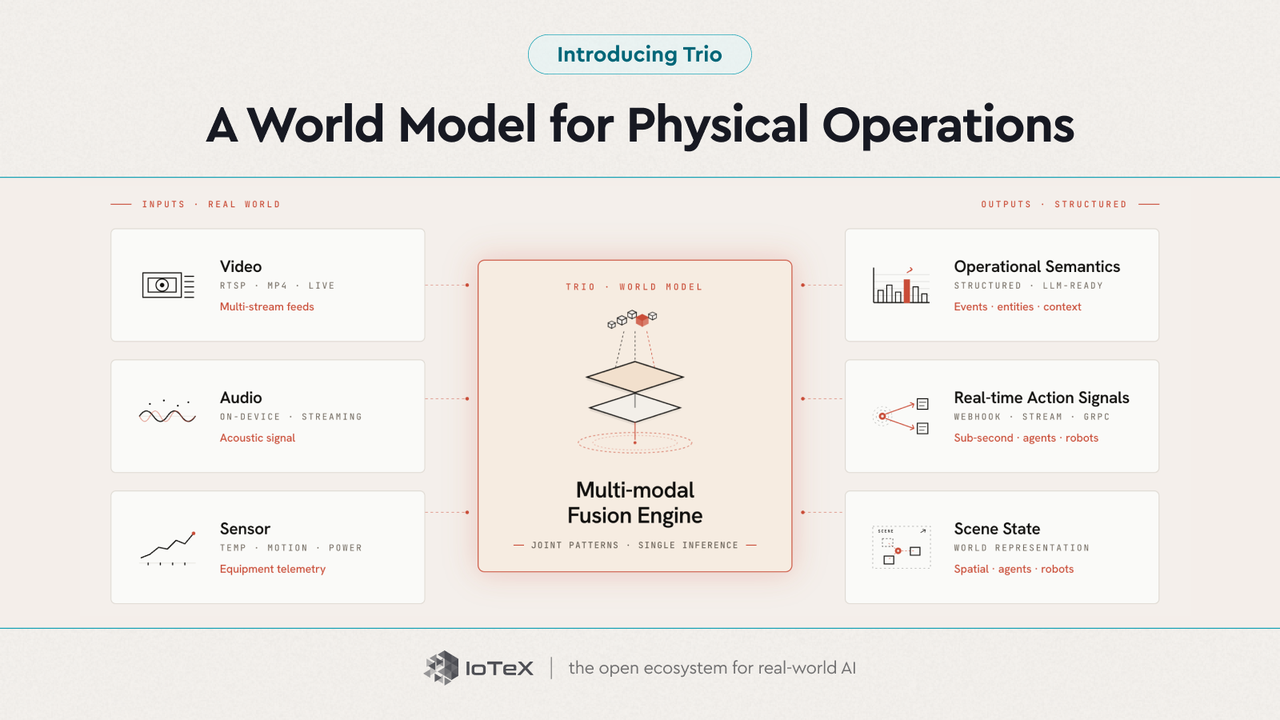
Đó chính là mục đích của Trio. Trio là mô hình thế giới của chúng tôi dành cho các hoạt động vật lý — không phải một mô hình đơn khối duy nhất, mà là một bộ ba sản phẩm cùng nhau nhận thức, dự đoán, và hành động dựa trên một hoạt động đang diễn ra trực tiếp. Trong khi một mô hình ngôn ngữ học cách văn bản vận hành, Trio học cách một địa điểm vận hành — những gì có trong đó, nó di chuyển như thế nào, điều gì sẽ xảy ra tiếp theo — cho hoạt động của bạn, từ những camera và cảm biến bạn đã có sẵn. Chúng tôi không thay thế các mô hình ngôn ngữ; chúng tôi mang đến cho chúng thế giới vật lý.
Trio vận hành vòng lặp đó qua ba giai đoạn — và nó được triển khai theo đúng thứ tự đó. Nhận thức (Perception) đã hoạt động trực tiếp ngay hôm nay; dự đoán (foresight) và hành động (action) là những gì sắp tới.
NHẬN THỨC → DỰ ĐOÁN → HÀNH ĐỘNG
- Nhận thức — Quan sát · Thấu hiểu — Trio-Retina · Trio-Lumen — Đang hoạt động
- Dự đoán — Dự báo · lập luận trước — Sắp tới
- Hành động — Khép kín vòng lặp — Sau này
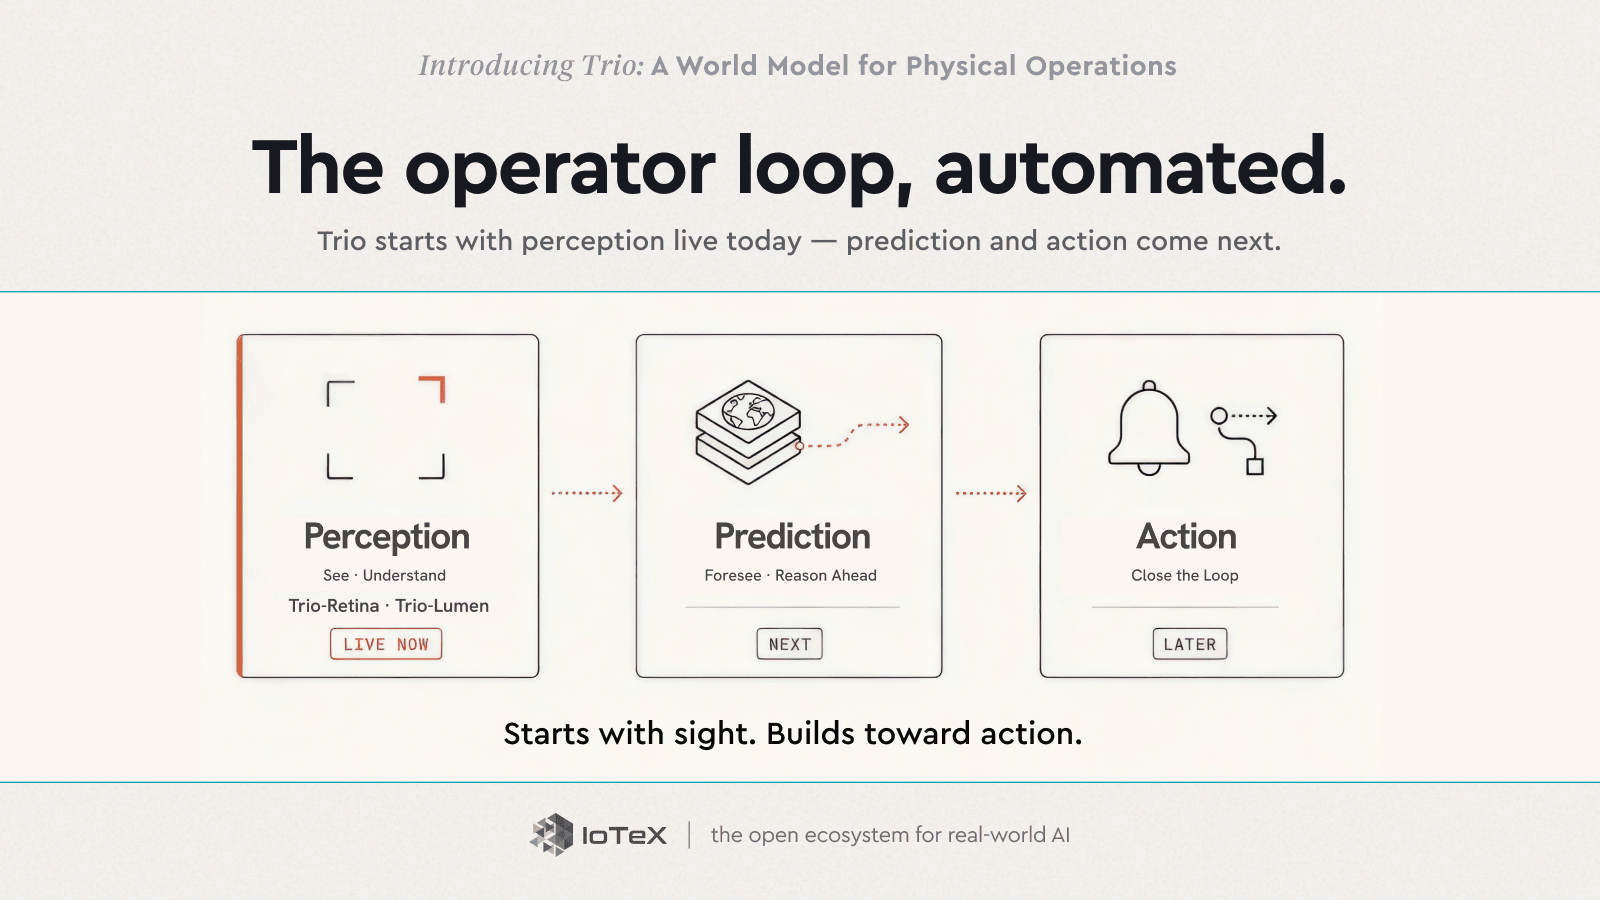
Ngày hôm nay, hai trong số đó đã thành hiện thực và nằm trong tay bạn. Trio-Retina (Quan sát) biến bất kỳ luồng camera nào thành một bản đọc tiêu chuẩn, trực tiếp về những gì đang diễn ra — ai đang ở đâu, họ đang làm gì, họ đang hướng đến đâu. Trio-Lumen (Thấu hiểu) giúp điều đó có thể lập trình được bằng ngôn ngữ đơn giản — “đánh dấu bất kỳ ai ở khu vực bốc dỡ hàng sau giờ làm việc” — theo dõi từng khung hình suốt ngày đêm và biến nó thành các sự kiện và cảnh báo. Nhận thức và thấu hiểu, đã sẵn sàng triển khai ngay hôm nay.
pip install trio-retinaTrio-Retina là mã nguồn mở — chạy trên máy của riêng bạn, hoặc dùng thử trực tiếp tại Playground.
Hai yếu tố đó là nền tảng cho phần còn lại được xây dựng lên. Dự đoán và hành động — lường trước rắc rối trước khi nó xảy ra, rồi hành động ngay tại hiện trường — là các giai đoạn tiếp theo của vòng lặp. Thứ tự này là có chủ đích: bạn không thể dự đoán được điều mà bạn chưa thể nhìn thấy, vì vậy chúng tôi xây dựng khả năng nhìn trước tiên.
Một mô hình được huấn luyện trên internet mở học cách thế giới trông như thế nào. Trio học cách vận hành của hoạt động của bạn.
Nó Trông Như Thế Nào Trong Một Nhà Kho
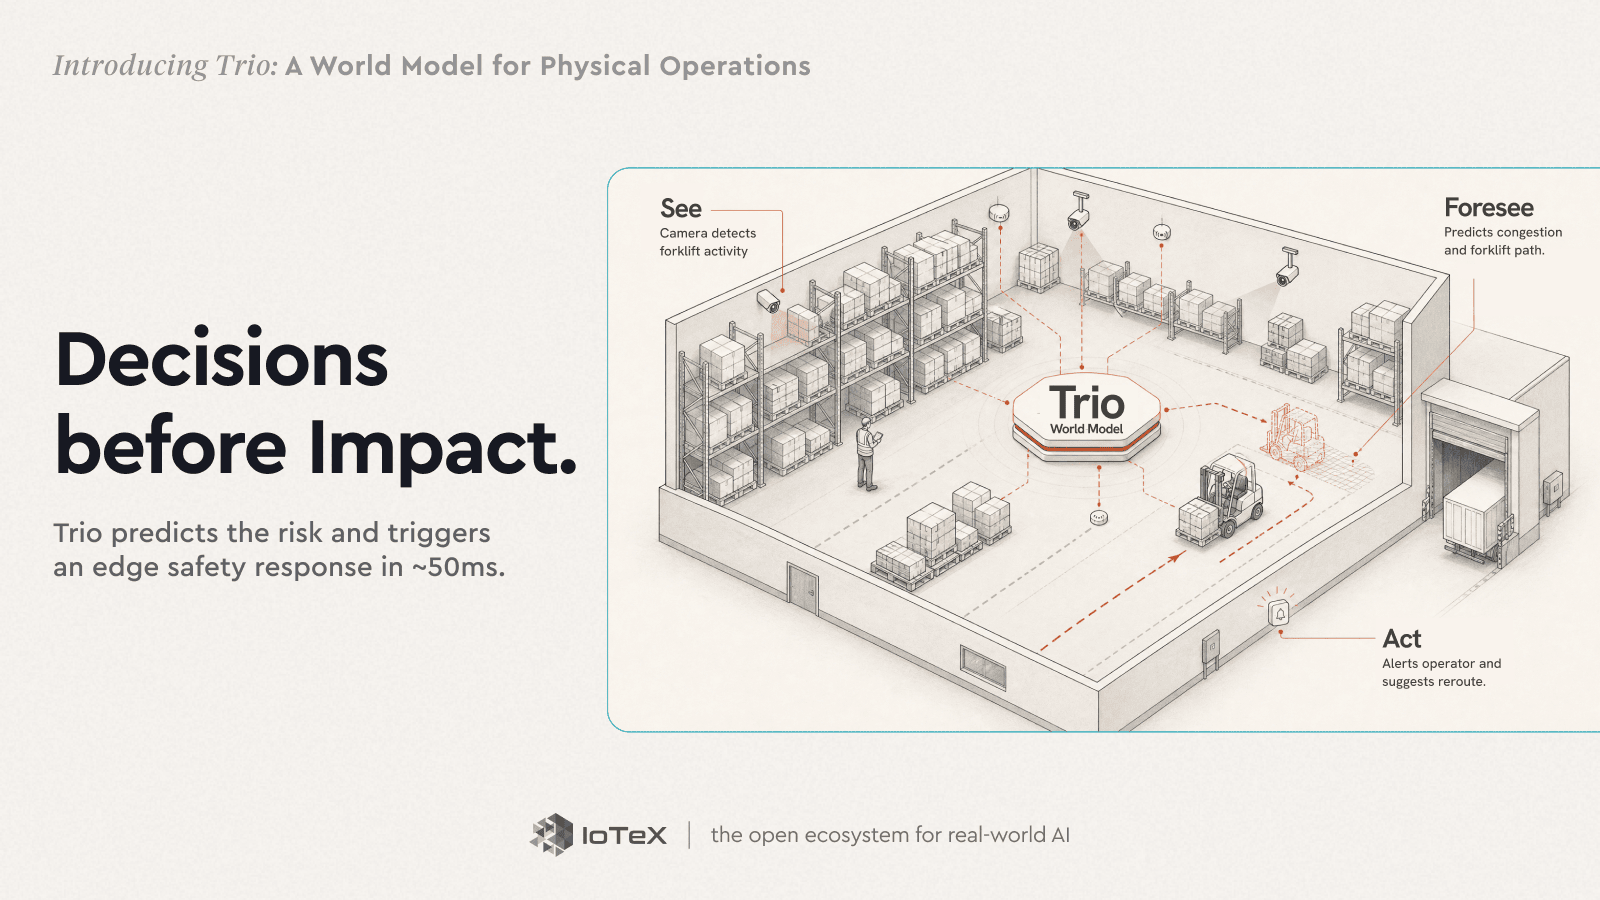
Bỏ qua phần trừu tượng. Một bến bốc dỡ hàng, giữa ca làm việc. Một xe nâng lùi ra khỏi khoang; một công nhân bước ra từ giữa hai kệ hàng trên một lối đi cắt ngang qua đó. Cả hai đều chưa thể nhìn thấy nhau.
Nhìn thấy — Trio-Retina, chạy trên một hộp nhỏ đặt cạnh camera, đã theo dõi được cả hai đối tượng: xe nâng và người, vị trí của họ, và hướng di chuyển của mỗi bên.
Dự đoán — mô hình thế giới của Trio dự đoán trước hai giây tiếp theo. Hai đường đi giao nhau. Nó đã từng thấy chính xác hình thái này kết thúc tồi tệ trước đây.
Hành động — một cổng an toàn biên tất định kích hoạt báo động giao cắt trong khoảng 50 mili giây — nhanh hơn khả năng phản ứng của cả hai người — và xe nâng được báo hiệu dừng lại. Một tình huống suýt xảy ra tai nạn thay vì một báo cáo sự cố.
Đó là toàn bộ luận điểm chỉ trong một khung hình: không phải là đoạn phim bạn xem lại sau khi sự việc xảy ra, mà là một quyết định được đưa ra ngay khoảnh khắc trước khi nó xảy ra.
Một Mô Hình Thế Giới Thực — Và Điểm Khác Biệt Của Chúng Tôi
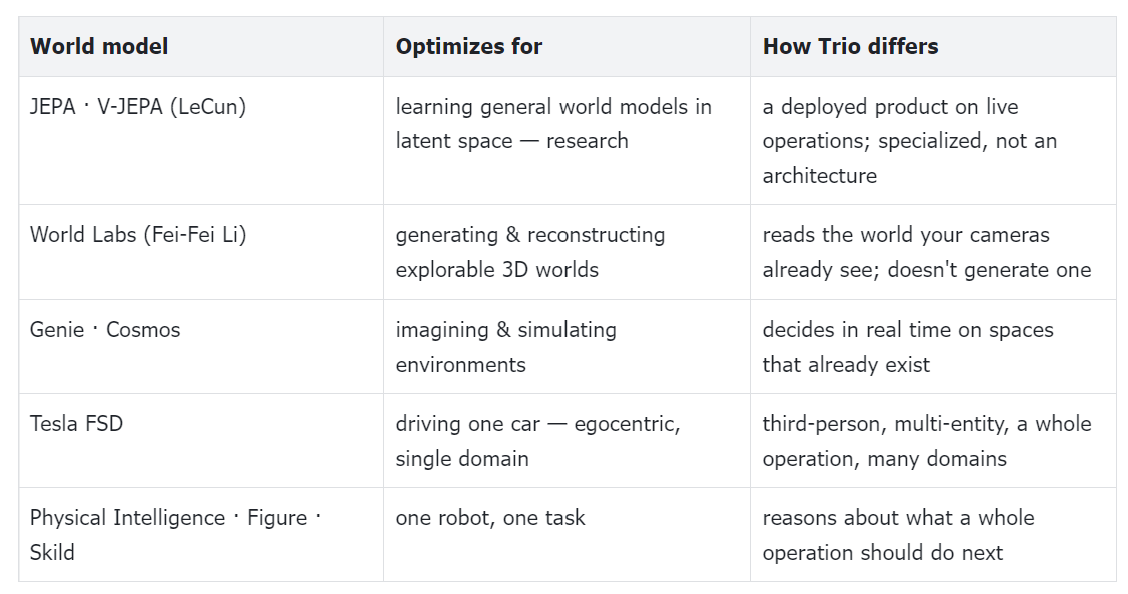
Trio nằm trong một lĩnh vực đang phát triển nhanh chóng. Mô hình thế giới là nơi nhiều bộ óc AI hàng đầu hiện đang hướng tới. Ý tưởng này bắt nguồn từ công trình World Models (2018) của Ha & Schmidhuber — một tác nhân học một mô hình thu gọn về môi trường của nó và “mơ” các mô phỏng bên trong đó. Yann LeCun lập luận rằng một mô hình thế giới dự đoán trong không gian tiềm ẩn (JEPA của ông) là mảnh ghép còn thiếu trên con đường hướng tới trí tuệ máy tự động; Fei-Fei Li gọi biên giới này là trí tuệ không gian, và World Labs của bà xây dựng các mô hình tạo ra các thế giới 3D có thể khám phá được. Lĩnh vực này gần như chia thành các nhóm:
- Dự đoán tiềm ẩn — V-JEPA 2 (Meta) và dòng sản phẩm Dreamer học động lực học trong không gian tiềm ẩn và lập kế hoạch bên trong đó.
- Thế giới tạo sinh & tương tác — Genie 3 (DeepMind), NVIDIA Cosmos, và Marble của World Labs tưởng tượng và tạo ra các môi trường.
- Lái xe — Tesla FSD và GAIA-2 của Wayve vận hành các mô hình thế giới được triển khai nhiều nhất trên Trái đất — cho một chiếc xe.
- Robot học — Physical Intelligence, Skild AI, và Figure xây dựng các mô hình nền tảng cho một robot duy nhất.
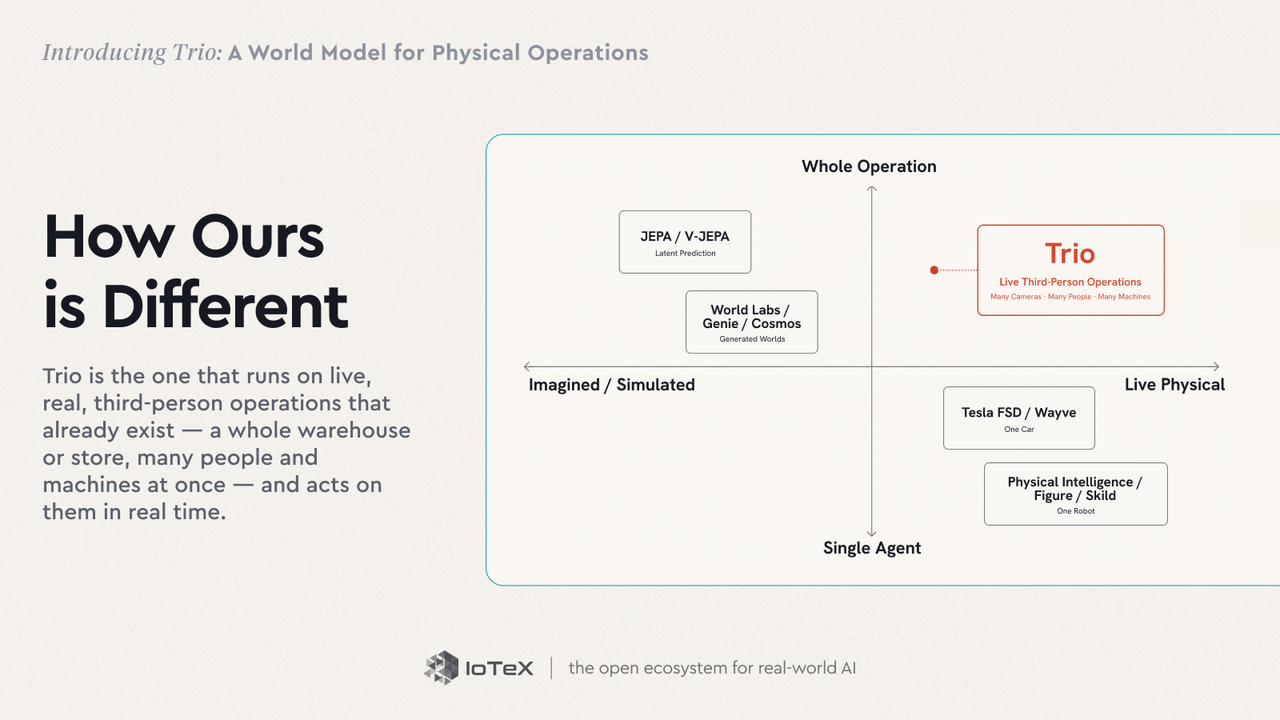
Hầu hết tất cả trong số đó đều tưởng tượng hoặc mô phỏng một thế giới, hoặc mô hình hóa lĩnh vực lấy góc nhìn bản thân của một tác nhân duy nhất — một chiếc xe, một robot. Trio là cái chạy trên các hoạt động thực, trực tiếp, ở góc nhìn người thứ ba đã tồn tại sẵn — cả một nhà kho hoặc cửa hàng, nhiều người và máy móc cùng lúc — và hành động dựa trên chúng theo thời gian thực.
Hai trục làm Trio nổi bật. Về mặt kỹ thuật — nó nhỏ, nhanh và chuyên biệt: thời gian thực tại biên, mức sàn gần 0,004 USD cho mỗi truy vấn, tính phí theo từng quyết định, một nền tảng cố định cộng với các adapter nhỏ theo từng địa điểm (LoRA, được huấn luyện trong vài giờ GPU) thay vì chạy lại một mô hình tổng quát khổng lồ trên từng khung hình. Trên benchmark streaming OVBench, việc bọc một mô hình open-weights trong stack của Trio giúp tăng độ chính xác +2,3 điểm chỉ nhờ kiến trúc, và khả năng nhận thức của nó truyền theo dòng mà không bị giới hạn thời lượng cố định như các mô hình hàng đầu. Theo kịch bản — nó vận hành trên các hoạt động đã tồn tại sẵn, và hành động dựa trên chúng ngay bây giờ, thay vì tưởng tượng ra một thế giới, lái một chiếc xe, hay điều khiển một robot.
Trio Được Xây Dựng Như Thế Nào
Dành cho các đội kỹ thuật: đây là cách Trio duy trì tốc độ nhanh và đủ rẻ để chạy trên mọi camera, cả ngày. Nếu bạn đến đây vì câu chuyện vận hành, hãy lướt qua — phần thưởng nằm ở câu cuối cùng.
Năm nguyên tắc giữ cho hệ thống gắn kết với nhau: mọi giao diện giữa các lớp đều là một biểu đồ cảnh (scene graph) được định kiểu chặt chẽ, có thể kiểm tra (không bao giờ là một vector mờ đục); một bộ định tuyến (router) kiểm soát chi phí, chạy liên tục các lớp rẻ tiền và chỉ đánh thức khả năng suy luận tốn kém khi cần thiết; các công cụ là hai chiều, để lớp suy luận có thể ra lệnh cho các lớp thấp hơn kiểm tra lại hoặc mô phỏng lại; mọi quyết định đều đi kèm bằng chứng của nó, để người vận hành có thể kiểm tra, phản biện và ghi đè; và các mô hình nền tảng vẫn được giữ cố định trong khi các adapter nhỏ theo từng triển khai — các module LoRA và một adapter kết hợp đa tầng (cross-tier fusion adapter), được huấn luyện trong vài giờ GPU thay vì huấn luyện lại toàn bộ — chuyên biệt hóa cho từng địa điểm.
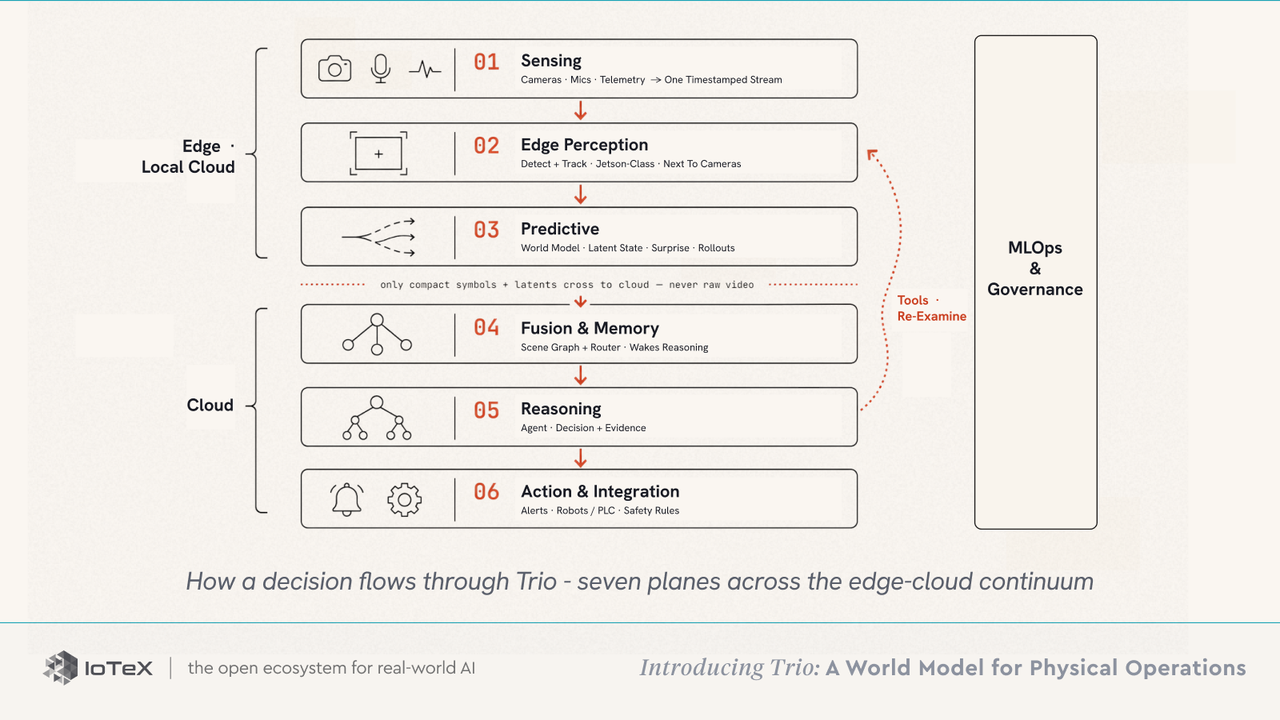
Những nguyên tắc đó được hiện thực hóa thành bảy mặt phẳng — sáu mặt nằm trong đường đi của một quyết định, cộng với quản trị xuyên suốt tất cả: Cảm biến (camera · micro · dữ liệu từ xa → một luồng có dấu thời gian) → Nhận thức Biên (phát hiện + theo dõi, lớp Jetson, đặt cạnh camera) → Dự đoán (mô hình thế giới: trạng thái tiềm ẩn · bất ngờ · mô phỏng) → Kết hợp & Bộ nhớ (biểu đồ cảnh + bộ định tuyến đánh thức suy luận) → Suy luận (tác nhân → quyết định đi kèm bằng chứng của nó) → Hành động & Tích hợp (cảnh báo · robot / PLC · các quy tắc an toàn độc lập), với MLOps & Quản trị xuyên suốt tất cả.
Vì nhận thức và dự đoán chạy cục bộ và chỉ các ký hiệu nén và biểu diễn tiềm ẩn được truyền lên đám mây — không bao giờ là video thô — Trio được tính phí theo từng quyết định, không phải theo token trên mỗi khung hình.
Trio Vận Hành Ở Đâu
Nhà kho chỉ là một khung hình. Nhà hàng, tiệm rửa xe, cửa hàng, nhà máy mà chúng ta mở đầu — cùng một mô hình đó hướng đến bất kỳ hoạt động nào vận hành bằng camera, ngày nay song song với các người vận hành, làm nổi bật những gì hệ thống hiện có của họ bỏ lỡ:
- Vận Hành Nhượng Quyền — Quản lý hàng đợi, giảm thất thoát, tuân thủ của nhân viên, phân tích luồng khách hàng.
- An Ninh & Kiểm Soát Ra Vào — Phát hiện xâm nhập, phân tích lảng vảng, ngăn chặn tailgating, thực thi ngoài giờ.
- Hậu Cần & Kho Vận — Trạng thái bến bãi, thời gian dừng của phương tiện, tuân thủ PPE, thực thi quy trình an toàn (SOP) trên toàn bộ sân bãi và mặt sàn.
- Sản Xuất & Công Nghiệp — Giám sát dây chuyền, phát hiện lỗi, cảnh báo nguy hiểm trên mọi dây chuyền và khu vực máy móc.
- Thành Phố Thông Minh — Đỗ xe, luồng giao thông, an toàn công cộng, giám sát hạ tầng trên các tuyến phố và giao thông công cộng.
- Y Tế & Khoa Học Sự Sống — Phát hiện té ngã, mô hình lưu trú, giám sát hành vi trên các phòng bệnh nhân và khuôn viên.
- Khách Sạn & Địa Điểm Sự Kiện — Quản lý đám đông, kiểm soát ra vào khu VIP, ứng phó sự cố theo thời gian thực ở quy mô lớn.
- Hạ Tầng Trọng Yếu — Giám sát chu vi 24/7, phát hiện xâm nhập, phản ứng tự động cho các địa điểm không thể bỏ lỡ một cảnh báo nào.
Những Gì Chúng Tôi Đã Xây Dựng — Và Điều Tiếp Theo
Trio không còn là một luận điểm trên bảng trắng nữa. Báo cáo kỹ thuật v1.0 chính thức hóa toàn bộ hệ thống — chuỗi nhận thức–dự đoán–hành động, năm nguyên tắc, bảy mặt phẳng — với hai lĩnh vực tham chiếu được triển khai đầy đủ (một tiệm rửa xe và một nhà kho), đến tận tình huống suýt va chạm giữa xe nâng và người đi bộ ở trên, được phát hiện bởi một cổng an toàn biên xác định (deterministic edge safety gate) kích hoạt trong khoảng 50 mili giây, nằm hoàn toàn trong giới hạn 100 ms. Trio-Retina là mã nguồn mở (pip install trio-retina), và Playground đã hoạt động — hãy mở nó lên và xem Trio đọc cảnh quay thực tế ngay trên trình duyệt của bạn.
Ba yếu tố khiến thời điểm này trở nên chín muồi: chip biên (edge silicon) cuối cùng cũng có thể chạy suy luận vận hành theo thời gian thực mà không cần vòng lặp qua đám mây; khả năng hiểu cảnh đa thực thể đã vượt qua ngưỡng nghiên cứu mà nhận diện đơn vật thể chưa từng chạm tới; và các nhà vận hành môi trường vật lý đã sẵn sàng cho thứ có thể là năng lực bị định giá thấp nhất trong AI hiện nay — một mô hình thế giới (world model) đặt trên chính những camera họ đã sở hữu, không cần phần cứng mới. Từ đây, Trio trưởng thành dần theo vòng lặp — từ việc nhìn thấy và thấu hiểu hôm nay tiến tới dự đoán, và theo thời gian, hành động trên thực địa.
Bắt đầu với Trio ngay hôm nay
Hai cách để tham gia — cả hai đều đang hoạt động ngay lúc này:
XÂY DỰNG TRÊN NỀN TẢNG NÀY · DÀNH CHO NHÀ PHÁT TRIỂN — Trio-Retina trên GitHub. Lớp nhận thức mã nguồn mở — lớp trạng thái không phụ thuộc mô hình (model-agnostic) biến bất kỳ bộ phát hiện nào thành một luồng sự kiện chuẩn hóa cùng trạng thái tiềm ẩn. pip install trio-retina và chạy trên máy của riêng bạn.
TRẢI NGHIỆM NGAY · DÀNH CHO NHÀ VẬN HÀNH — Trio-Lumen trên nền tảng. Xem hoạt động của bạn trở nên sống động ngay trên trình duyệt — Trio đọc hình ảnh video thực tế thành các vật thể có trạng thái và đám đông thành dòng chảy, sau đó hướng nó vào chính camera của bạn và đặt câu hỏi bằng ngôn ngữ tự nhiên.
Trio, IoTeX, và Nền Kinh Tế Máy Móc
Trio không xuất hiện từ hư không. Nó được xây dựng trên nền tảng một thập kỷ phát triển của IoTeX — hạ tầng và mạng lưới thiết bị kết nối, danh tính thiết bị (ioID), dữ liệu máy có thể xác minh (Quicksilver), và thanh toán giữa máy với máy (x402) mà AI trong thế giới thực cần để hiện diện với dữ liệu, danh tính và sự tin cậy đứng sau. Và Trio chính là sản phẩm hiện thực hóa tầm nhìn của IoTeX: Thử Thách 1 đặt mục tiêu biến IoTeX thành giao diện mà qua đó AI nhìn thấy, xác minh, và hành động trên thế giới vật lý, và Trio chính là đôi mắt đó.
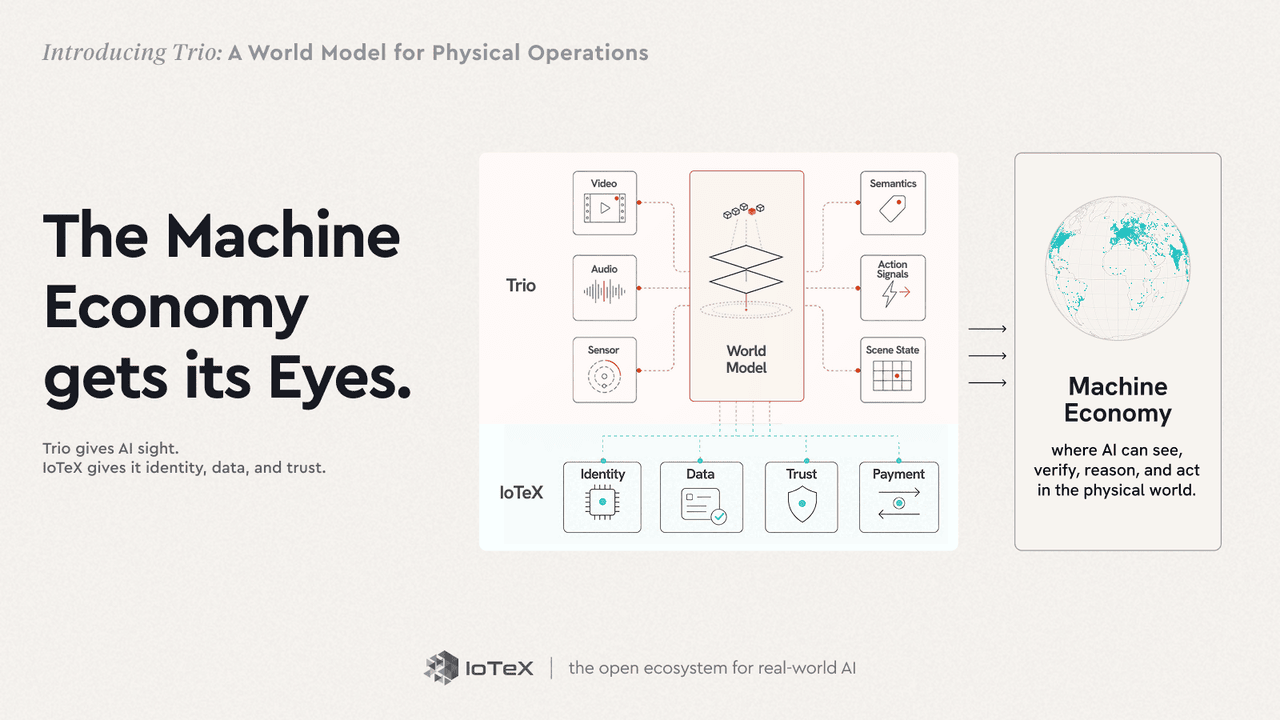
Ghép lại, bạn sẽ có nền kinh tế máy móc mà Anti-Roadmap đã mô tả. Máy móc cần ba điều: nhìn thấy thế giới, tin tưởng vào những gì chúng thấy, và hành động dựa trên đó. IoTeX cung cấp sự tin cậy phi tập trung, trong khi Trio cung cấp đôi mắt và đôi tai để cảm nhận thực tế vật lý — cùng bộ não để suy luận và hành động dựa trên đó.
Tiếp tục tiến bước…
Thử Thách 1 giờ đã có lời giải. Trao cho AI đôi mắt trên thế giới vật lý và biến nó thành hiện thực — đó là thử thách đầu tiên và mang tính sống còn nhất trong Anti-Roadmap 2026 của chúng tôi. Chúng tôi đã tìm ra con đường, và đã xây dựng với tốc độ tối đa kể từ đó. Trio là AI thế giới thực có sản phẩm thực sự, không phải chỉ là bản trình chiếu — nó chạy trên những camera đã có sẵn và biến chúng thành giá trị ngay từ ngày đầu tiên.
Buổi ra mắt chính thức đang đến gần, và tương lai chúng tôi đã hứa gần như đã nằm trong tầm tay. Cảm ơn bạn đã đồng hành cùng chúng tôi và hãy tiếp tục đón chờ.
— Đội ngũ IoTeX
Đọc thêm về các mô hình thế giới
- D. Ha, J. Schmidhuber. World Models. 2018.
- Y. LeCun. A Path Towards Autonomous Machine Intelligence. 2022. (giới thiệu JEPA)
- F.-F. Li. From Words to Worlds: Spatial Intelligence is AI’s Next Frontier. 2025. (World Labs)
- D. Hafner, W. Yan, T. Lillicrap. Training Agents Inside of Scalable World Models (DreamerV4). 2025.
- Meta AI. V-JEPA 2. 2025.
- DeepMind. Genie 3. 2025.
- NVIDIA. Cosmos World Foundation Model Platform for Physical AI. 2025.
- Wayve. GAIA-2: a controllable multi-camera world model for driving. 2025.