
隆重推出 Trio——面向实体操作的世界模型

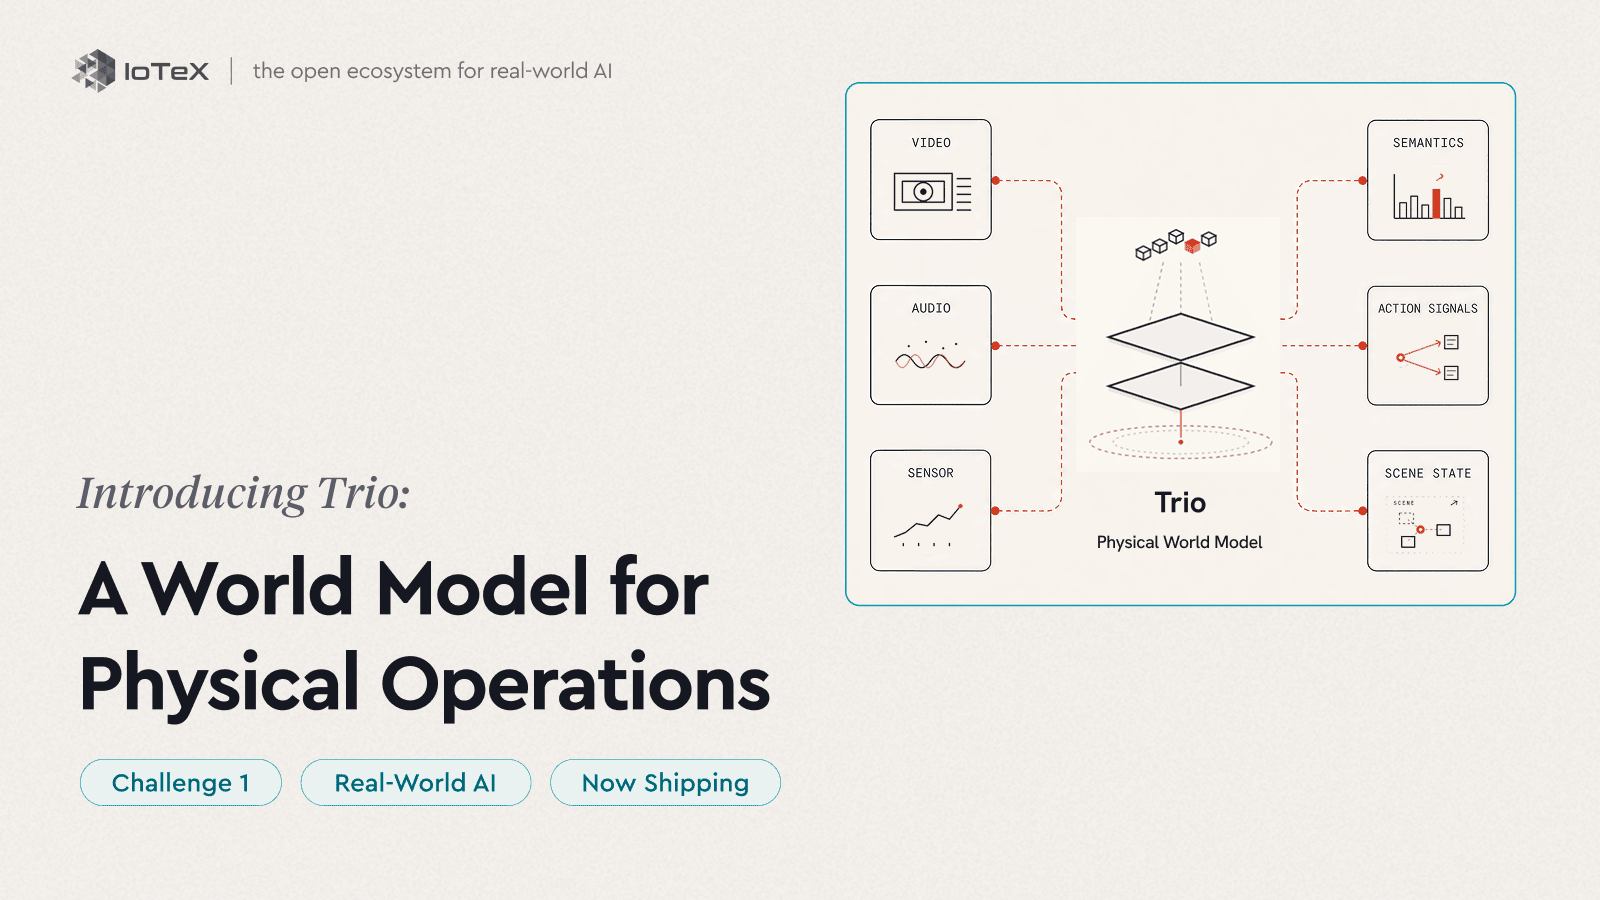
IoTeX 关于 Trio、真实世界人工智能,以及我们对反路线图(Anti-Roadmap)第一项挑战的回答的最新动态。
三月,IoTeX 发布了《2026年反路线图》——三项挑战,而非一份时间表。挑战一关乎生死存亡:成为人工智能通往物理世界的接口。我们的答案很具体——视觉先行,把任何实时视频流转化为智能,让你的物理运营能够实时据此采取行动。这个答案就是 Trio,一个面向物理运营的世界模型,由 IoTeX 核心团队在 MachineFi Lab 打造。我们接受了这项挑战,现在,我们正在交付成果。
纵观历史,物理世界一直由人来运转。一个人观察正在发生的事,判断其含义,并据此采取行动——开卡车、操作产线、巡视现场。感知、预测、行动:这个闭环中一直都需要人的参与。
人工智能首先改变了数字世界——语言、代码、图像。现在,它开始进军物理世界。有能在实时车流中开车的人工智能。有通过想象游戏玩法来学习电子游戏的人工智能。有能叠一堆衣物的机器人。支撑这一切的底层能力——让机器观察局势、想象接下来会发生什么、并据此行动的能力——就是世界模型。Trio 是一种新型的世界模型:它让人工智能能够实时“看见”整个运营流程。
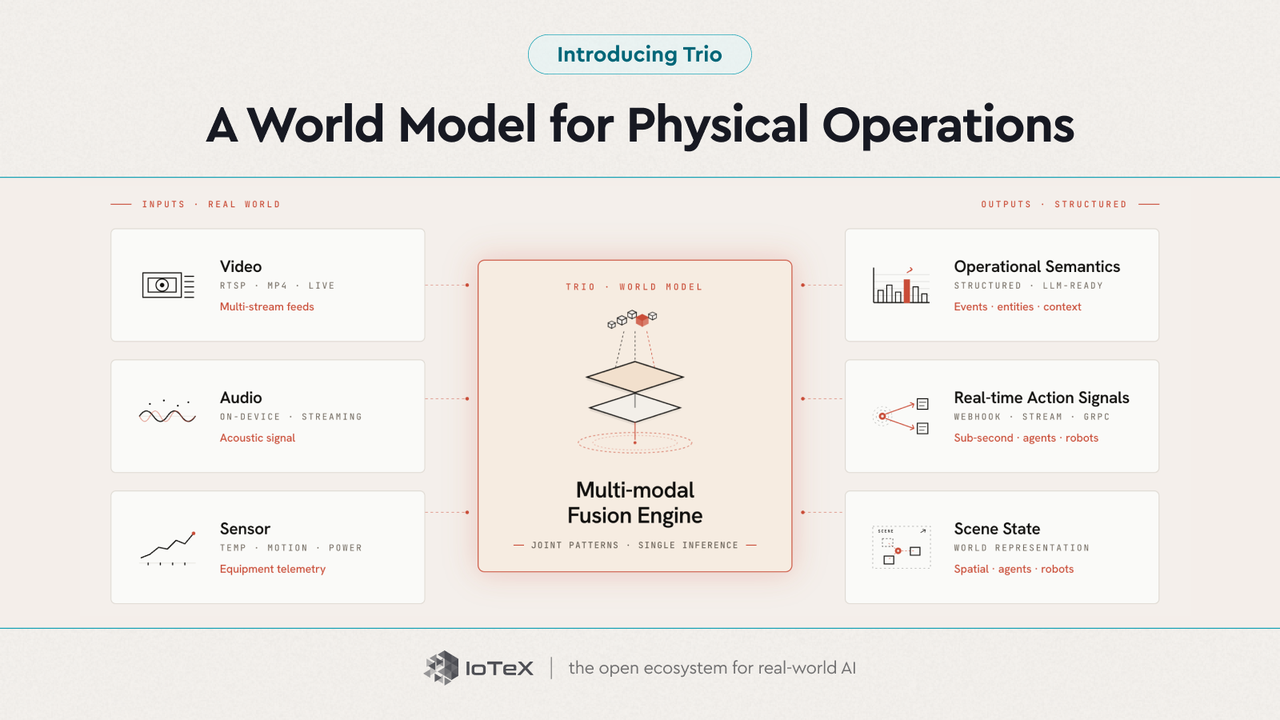
上述那些例子刻意做得很“窄”:一辆车、一个游戏、一个机器人、一个任务。但最大的物理场景早已布满线路、时刻被监控——遍布每个仓库、商店、工厂和护理场所的摄像头……一个能够运行在这些场景之上——处理整个实时运营——的世界模型,正是挑战一所呼唤的那种接口。这正是 Trio 存在的意义。
什么是 Trio
请注意这四个例子的共同点:它们各自只运行一件事——一辆车、一个游戏、一个机器人、一个虚拟世界。它们都没有运行一个运营流程。而这恰恰是物理经济真正存在的地方——午餐高峰期的餐厅、循环清洗车辆的洗车店、正在装货的仓库、正在营业的商店、一条工厂产线——这些地方有数十号人、车辆和机器同时不间断运转,全都被摄像头拍摄着,却没人有时间去看。
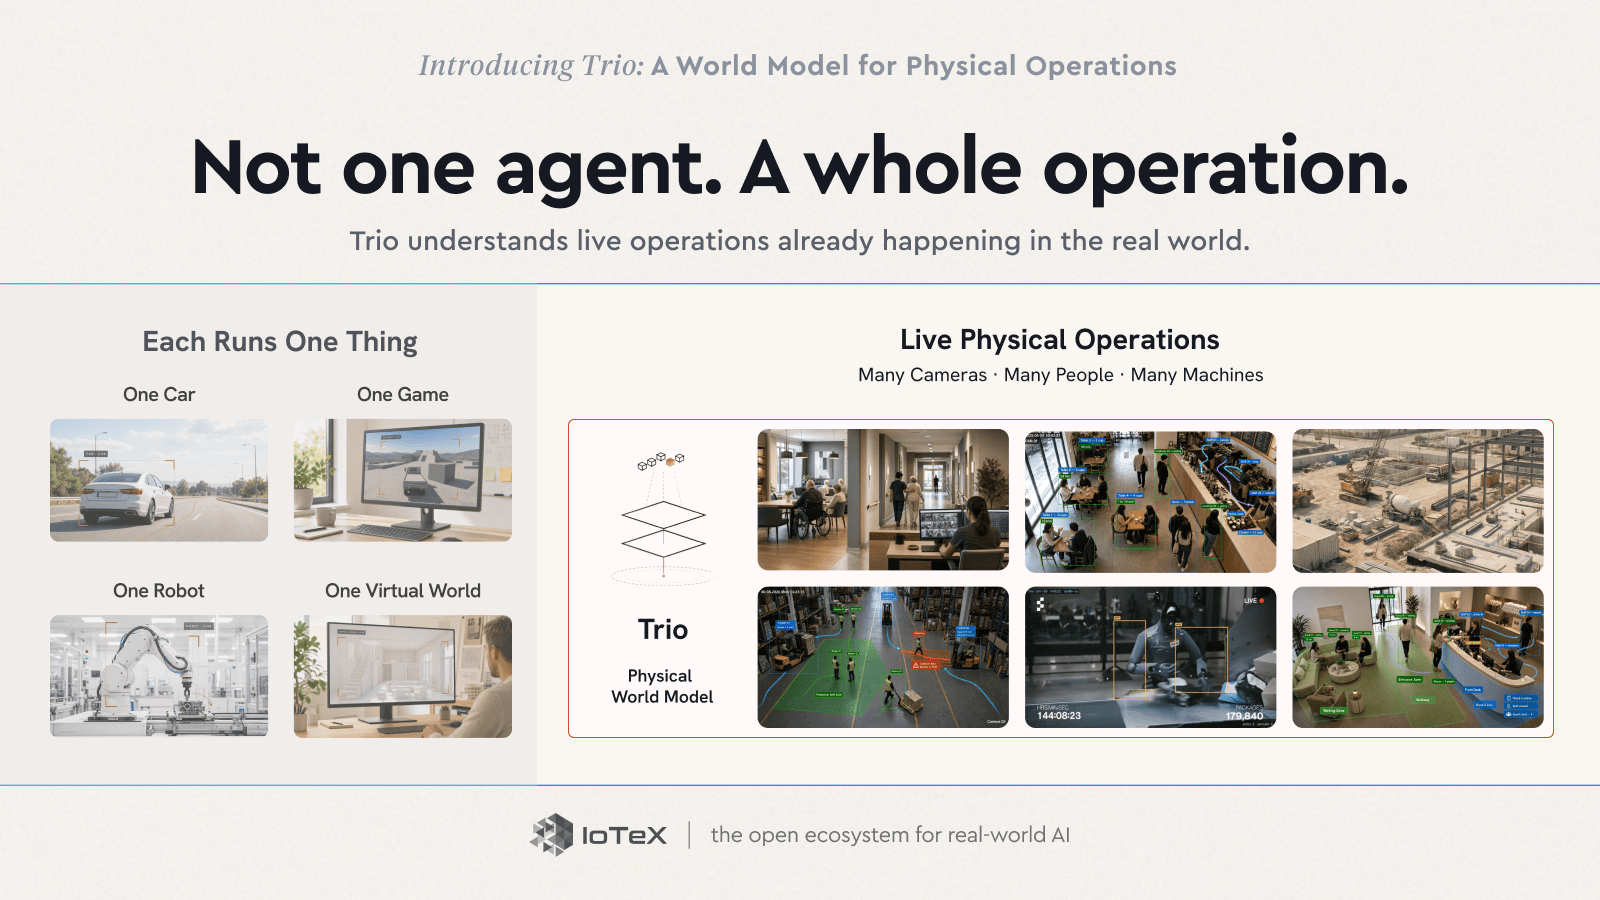
这正是 Trio 的用武之地。Trio 是我们面向物理运营打造的世界模型——它不是一个单一的整体模型,而是一套由三个产品组成的套件,共同实现对实时运营的感知、预测和行动。语言模型学习的是文本如何运作,而 Trio 学习的是一个场所如何运作——里面有什么、如何移动、接下来会发生什么——针对你的运营场景,利用你已有的摄像头和传感器。我们不是要取代语言模型,而是要为它们带来物理世界。
Trio 分三个阶段运行这个闭环——并且按此顺序逐步交付。感知功能今天已经上线;预见与行动即将推出。
感知 → 预测 → 行动
- 感知 —— 观察 · 理解 —— Trio-Retina · Trio-Lumen —— 现已上线
- 预测 —— 预见 · 提前推理 —— 即将推出
- 行动 —— 闭环 —— 稍后推出
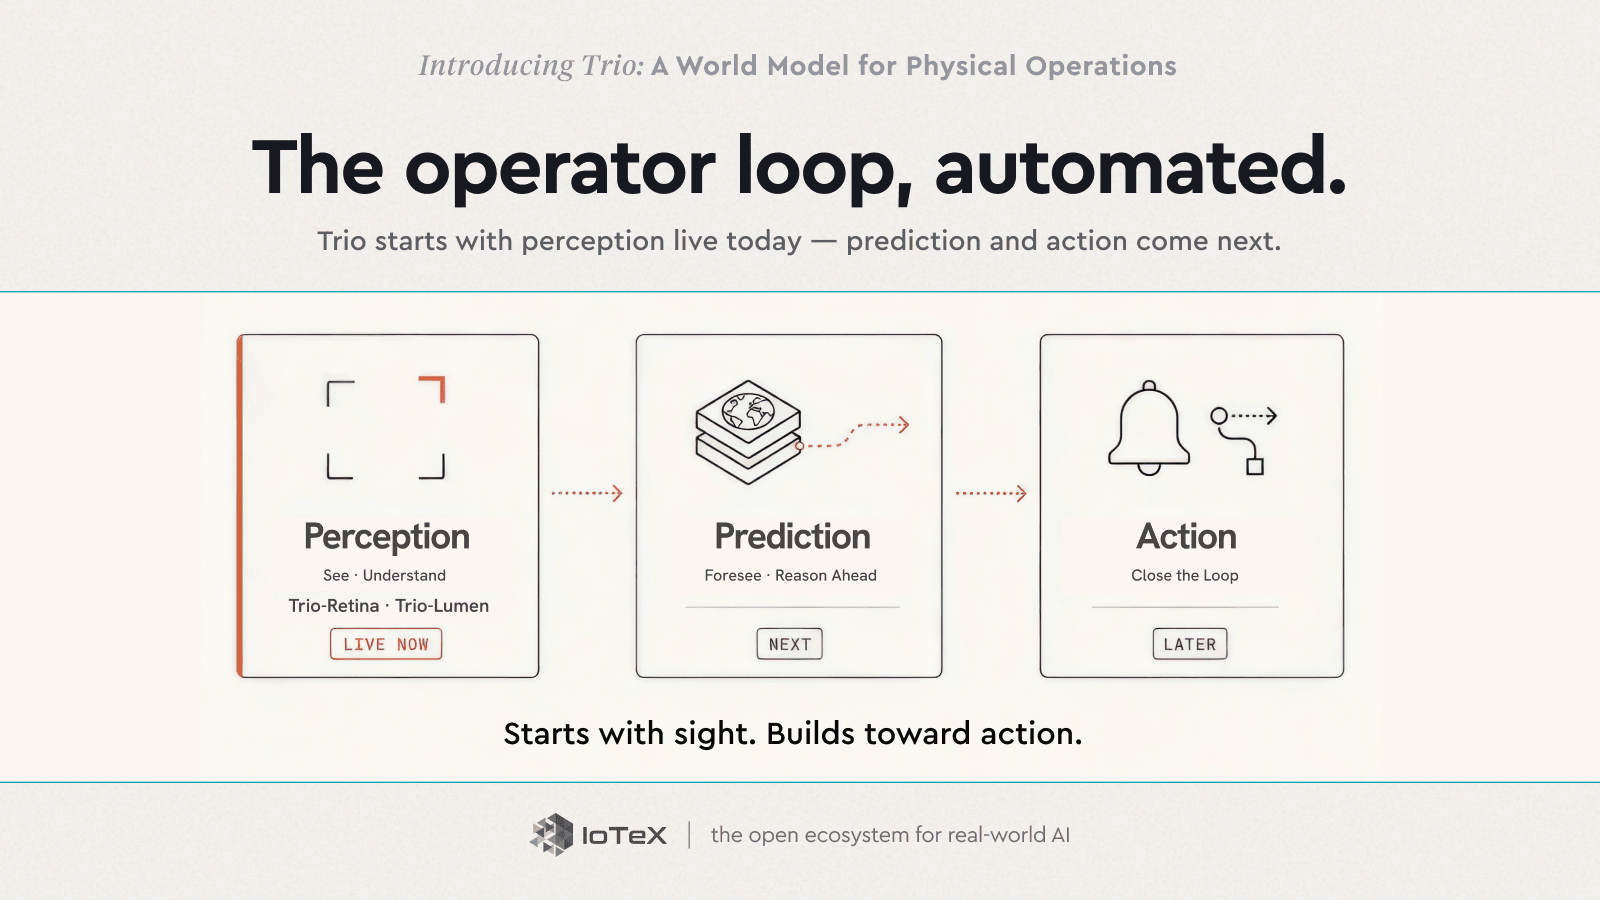
如今,这三个阶段中的两个已经真实存在,并已交到你手中。 Trio-Retina(观察)能将任何摄像头视频流转化为对当前情况的统一、实时解读——谁在哪里、正在做什么、正朝哪个方向前进。Trio-Lumen(理解)让这一切能够用简单的英语进行编程——比如“标记装卸区下班后出现的任何人”——它全天候监看每一帧画面,并将其转化为事件和警报。感知与理解,今天即可使用。
pip install trio-retinaTrio-Retina 是开源的——可以在你自己的机器上运行,也可以在 Playground 中实时体验。
这两者是其余部分建立的基础。预见和行动——在麻烦发生之前预见它,然后在现场采取行动——是这个循环的下一个阶段。这个顺序是有意为之的:你无法预见你还看不到的东西,所以我们首先建立了“看见”的能力。
一个在开放互联网上训练的模型学会了世界的样子。而 Trio 学会的是你的运营方式。
在一个仓库中它是什么样子
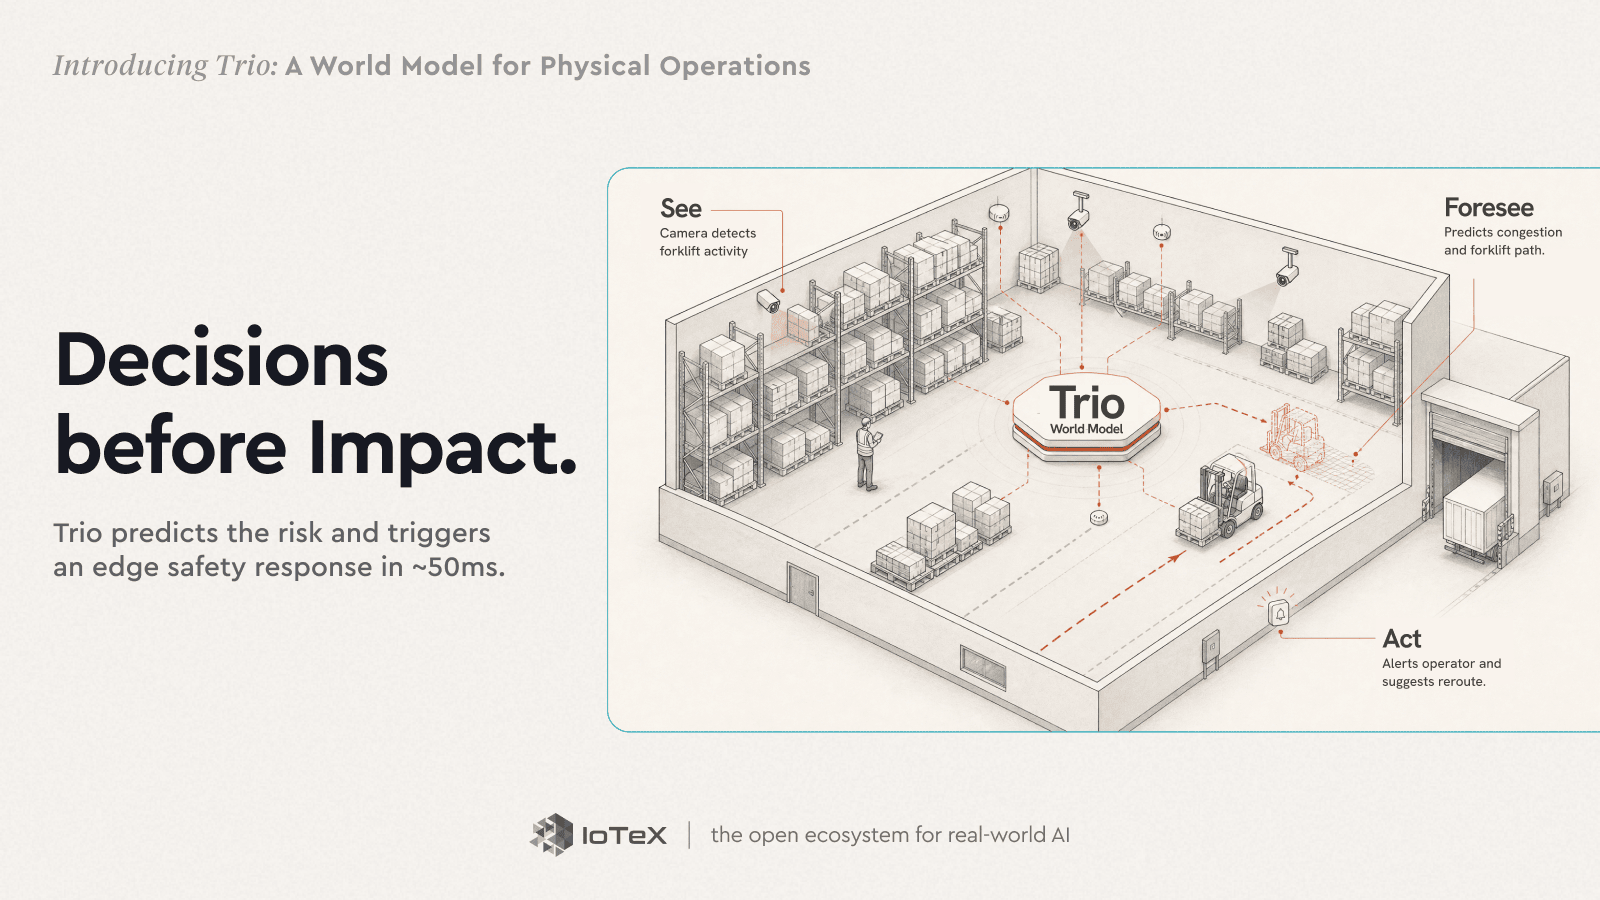
抛开抽象概念。一个装卸码头,正值换班时段。一辆叉车从一个货位倒车驶出;一名工人从两排货架之间走出来,走在一条与其交叉的路径上。双方都还看不见对方。
看见——运行在摄像头旁一个小型设备上的 Trio-Retina,已经将两者都识别为被追踪的对象:叉车和人,以及他们各自的位置和前进方向。
预见——Trio 的世界模型将接下来两秒钟的情况向前推演。两条路径将相交。它以前见过这种确切的几何关系,并且结果不妙。
行动——一个确定性的边缘安全网关在大约 50 毫秒内触发交叉路口警报——比任何人的反应速度都快——同时向叉车发出停止信号。这是一次险情,而不是一份事故报告。
这就是整个理论在一个画面中的体现:不是事后调取的录像,而是在事情发生之前那一刻做出的决定。
一个真正的世界模型——以及我们的模型有何不同
Trio 处于一个快速发展的领域之中。世界模型是当下许多 AI 顶尖人才关注的方向。这个想法可以追溯到 Ha 和 Schmidhuber 的《世界模型》(2018)——一个智能体学习其环境的紧凑模型,并在其中进行“梦境式”推演。Yann LeCun 认为,在潜在空间中的预测性世界模型(他提出的 JEPA)是通向自主机器智能道路上缺失的一环;李飞飞 将这一前沿领域称为空间智能,她的 World Labs 公司构建能够生成可探索三维世界的模型。这个领域大致可以分为以下几个阵营:
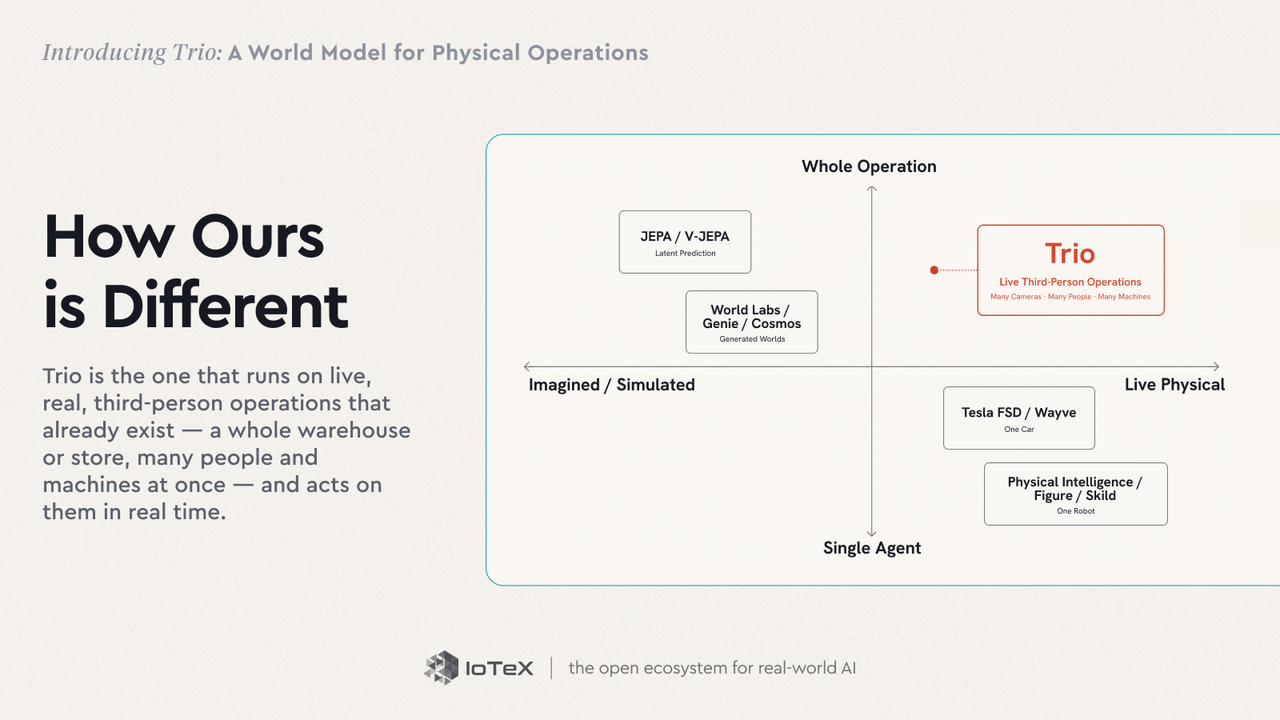
- 潜在空间预测——V-JEPA 2(Meta)和 Dreamer 系列在潜在空间中学习动态规律,并在其中进行规划。
- 生成式与交互式世界——Genie 3(DeepMind)、NVIDIA Cosmos 以及 World Labs 的 Marble 能够想象并生成环境。
- 驾驶领域——Tesla FSD 和 Wayve 的 GAIA-2 运行着地球上部署最广泛的世界模型——但仅针对一辆车。
- 机器人领域——Physical Intelligence、Skild AI 和 Figure 为单个机器人构建基础模型。
几乎所有这些模型要么是想象或模拟一个世界,要么是对单一智能体的第一人称视角领域进行建模——一辆车、一个机器人。而 Trio 是唯一一个运行在已经存在的真实、实时、第三人称视角运营场景之上的模型——整个仓库或商店,许多人和机器同时存在——并对其进行实时行动决策。
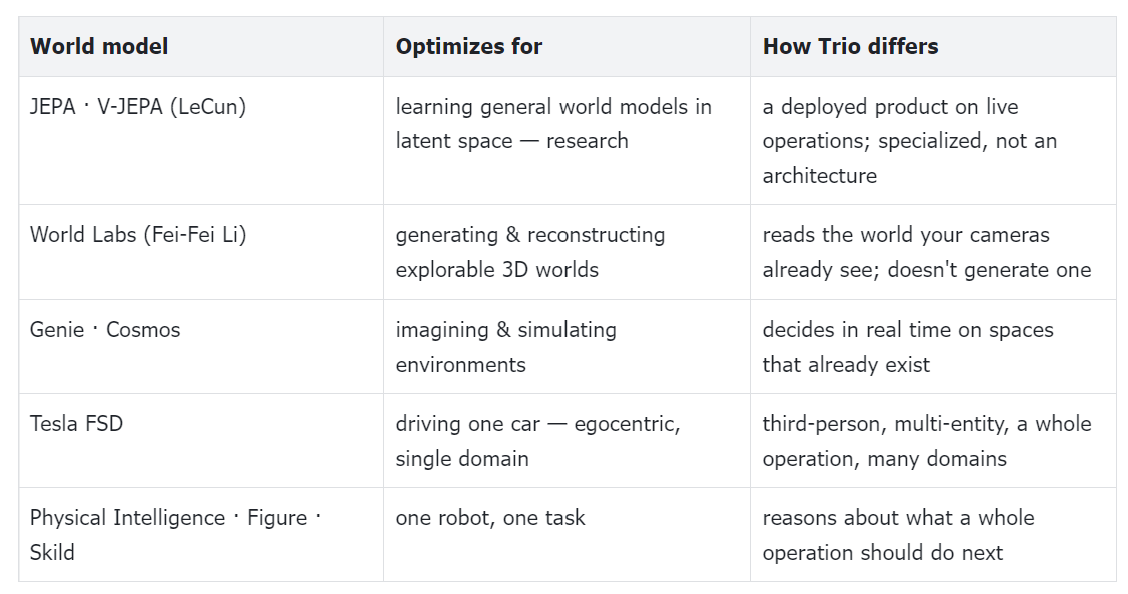
Trio 在两个维度上与众不同。从技术上讲——它小巧、快速且专业化:在边缘端实时运行,每次查询的成本下限接近 0.004 美元,按决策计费,采用冻结的基础模型加上针对每个站点的小型适配器(LoRA,以 GPU 小时为单位训练),而不是在每一帧上重新运行一个庞大的通用模型。在 OVBench 流式基准测试中,将开源权重模型封装进 Trio 的技术栈后,仅凭架构本身就能将准确率提升 2.3 个百分点,而且它的感知是持续流式的,不受前沿模型固定的分钟数限制。从应用场景上讲——它运行在已经存在的操作之上,并立即对其采取行动,而不是去想象一个世界、驾驶一辆车或操控一台机器人。
Trio 是如何构建的
面向技术团队:以下介绍 Trio 如何做到足够快速、足够便宜,从而可以在每个摄像头上全天候运行。如果你更关心业务应用场景,可以直接跳到最后一行——那才是重点。
五项原则将整个系统贯穿在一起:各层之间的每一个接口都是强类型、可检查的场景图(而非不透明的向量);一个路由器负责成本管理,持续运行低成本层,只有在需要时才唤醒昂贵的推理层;工具是双向的,因此推理层可以指令下层重新检查或重新模拟;每一个决策都附带其证据,以便操作员可以检查、质疑并否决它;基础模型保持冻结,而针对每个部署站点的小型适配器——LoRA 模块和跨层融合适配器(以 GPU 小时训练,而非完整重新训练)——负责对每个站点进行专门化调整。
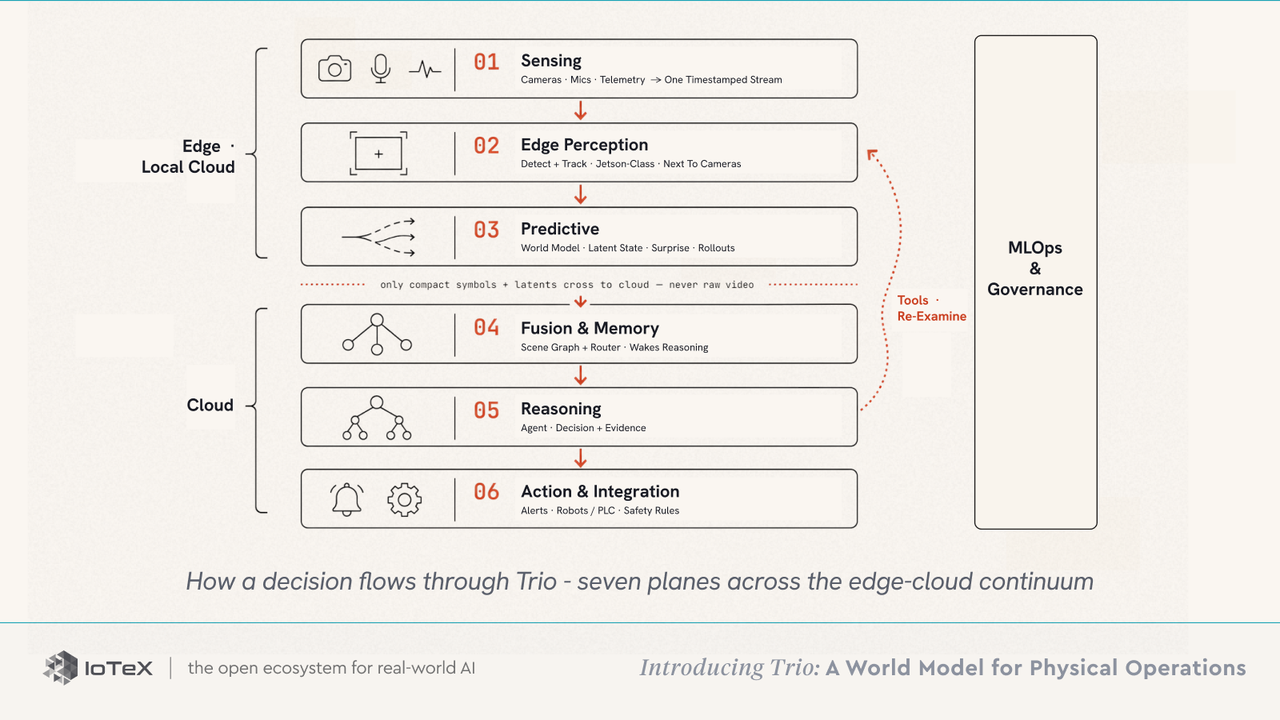
这些原则体现为七个平面——其中六个位于单次决策的路径中,另加一个贯穿全局的治理平面:感知(摄像头 · 麦克风 · 遥测数据 → 汇聚为一个带时间戳的流)→ 边缘感知(检测 + 跟踪,Jetson 级别,紧邻摄像头部署)→ 预测(世界模型:潜在状态 · 意外程度 · 推演)→ 融合与记忆(场景图 + 唤醒推理的路由器)→ 推理(智能体 → 与其证据配对的决策)→ 行动与集成(警报 · 机器人 / PLC · 独立的安全规则),而 MLOps 与治理则贯穿其中的每一个环节。
由于感知与预测都在本地运行,只有紧凑的符号和潜在表示会传输到云端——绝不传输原始视频——因此 Trio 按决策计费,而非按每帧的 token 数计费。
Trio 的应用场景
仓库只是其中一个场景。餐厅、洗车店、零售商店,以及我们最初介绍的工厂——同一个模型可以应用于任何依赖摄像头运行的业务场景,如今与现有的人工操作员协同工作,发现他们现有系统所遗漏的问题:
- 连锁门店运营 —— 排队管理、防损、员工合规、客流分析。
- 安全与门禁 —— 入侵检测、逗留分析、尾随防范、非营业时段管控。
- 物流与仓储 —— 货运码头状态监测、车辆停留时间、个人防护装备(PPE)合规、场地与楼面的安全流程执行。
- 制造与工业 —— 产线监控、缺陷检测、覆盖每条产线和每个机器区域的危险报警。
- 智慧城市 —— 停车管理、交通流量、公共安全、覆盖街道与交通枢纽的基础设施监测。
- 医疗与生命科学 —— 跌倒检测、入住模式分析、覆盖住户房间与园区的行为监测。
- 酒店与场馆 —— 人群管理、VIP 区域门禁控制、大规模实时事件响应。
- 关键基础设施 —— 全天候周界智能监控、入侵检测、面向绝不容许漏报场所的自主响应。
我们已经完成的工作——以及接下来的计划
Trio 不再只是白板上的一个构想。v1.0 技术报告正式阐述了整个系统——感知-预测-行动技术栈、五项原则、七个平面——并附有两个完整实现的参考领域(洗车店与仓库),细致到上文中那次由确定性边缘安全门在约 50 毫秒内触发的叉车与行人险情,远低于 100 毫秒的上限。Trio-Retina 已开源(pip install trio-retina),Playground 也已上线——打开它,在浏览器中观看 Trio 解读真实录像。
三股力量让此刻成为关键时刻:边缘芯片终于能够在无需云端往返的情况下运行实时运营推理;多实体场景理解已跨越了单一物体检测从未触及的研究门槛;而物理环境的运营者已经准备好迎接当今 AI 领域可能最被低估的能力——在他们已经拥有的摄像头之上构建一个世界模型,无需新增任何硬件。从这里开始,Trio 沿着这条成长曲线不断进化——从今天的看见与理解,走向预见,并在未来对现场进行实际行动。
立即开始使用 Trio
两种参与方式——现已全部上线:
动手构建 · 开发者 —— GitHub 上的 Trio-Retina。 这是开源感知层——一个模型无关的状态层,能将任意检测器转化为一条标准的事件流加潜在状态。pip install trio-retina,即可在你自己的机器上运行。
亲自体验 · 运营者 —— 平台上的 Trio-Lumen。 在浏览器中亲眼见证你的运营场景“活起来”——Trio 将真实画面中的物体解读为带状态的实体,将人群解读为流动,然后你可以将它对准自己的摄像头,用日常语言进行提问。
Trio、IoTeX 与机器经济
Trio 并非凭空而来。它建立在 IoTeX 十年积累之上——基础设施与联网设备网络、设备身份(ioID)、可验证的机器数据(Quicksilver),以及机器与机器之间的支付系统(x402),这些正是现实世界 AI 要真正落地所需要的数据、身份与信任支撑。而 Trio 正是将 IoTeX 愿景具体化的产品:Challenge 1 旨在让 IoTeX 成为 AI 感知、验证并作用于物理世界的接口,而 Trio 正是那双“眼睛”。
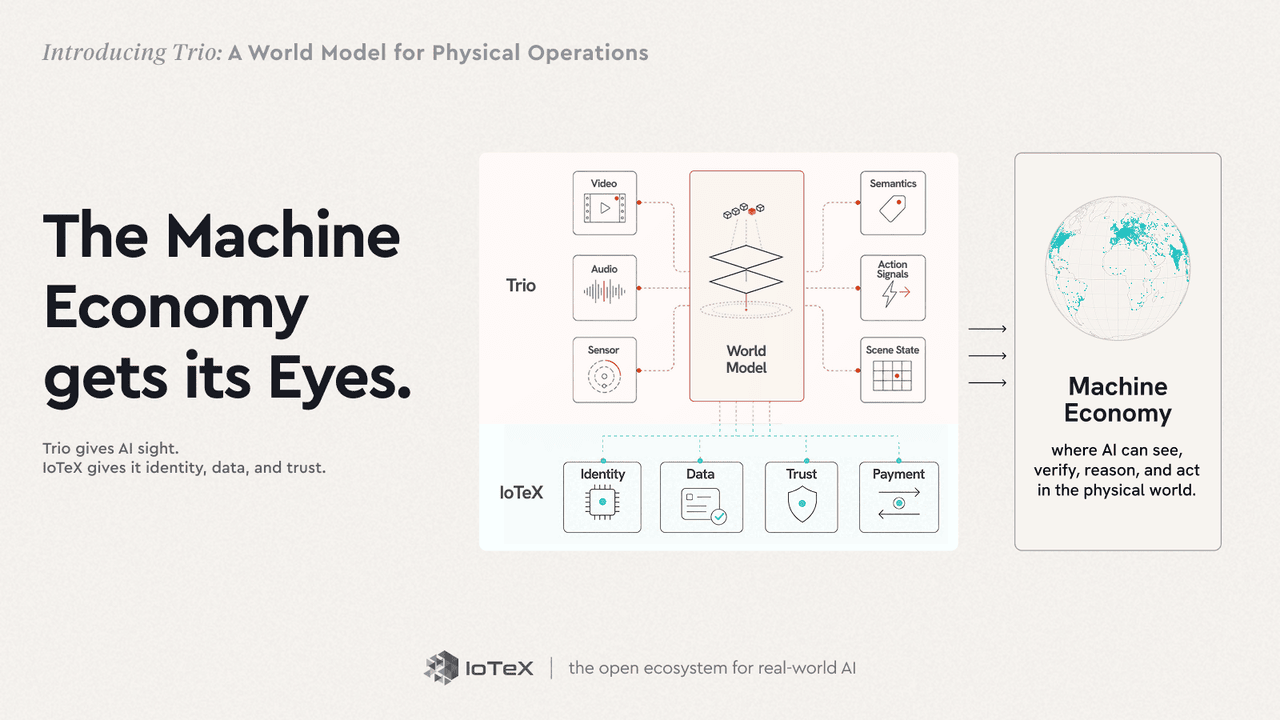
将这些结合起来,你便拥有了《Anti-Roadmap》所描绘的机器经济。机器需要三样东西:看见这个世界、信任所看到的内容,以及据此行动。IoTeX 提供去中心化的信任基础,而 Trio 则提供感知物理现实的眼睛与耳朵——以及推理并采取行动的大脑。
持续前行……
Challenge 1 如今已有答案。 赋予 AI 一双能看见物理世界的眼睛,并将其变为现实——这是我们《2026 反路线图》中提出的第一个、也是最具存在意义的挑战。我们找到了路径,并一直以全速推进建设。Trio 是真正落地的现实世界 AI,而非停留在幻灯片上的概念——它运行在已有的摄像头上,从第一天起就能创造价值。
正式发布已近在眼前,我们承诺的未来也即将触手可及。感谢大家与我们一同构建,敬请持续关注。
—— IoTeX 团队
关于世界模型的延伸阅读
- D. Ha, J. Schmidhuber. World Models. 2018.
- Y. LeCun. A Path Towards Autonomous Machine Intelligence. 2022.(提出 JEPA)
- F.-F. Li. From Words to Worlds: Spatial Intelligence is AI’s Next Frontier. 2025.(World Labs)
- D. Hafner, W. Yan, T. Lillicrap. Training Agents Inside of Scalable World Models (DreamerV4). 2025.
- Meta AI. V-JEPA 2. 2025.
- DeepMind. Genie 3. 2025.
- NVIDIA. Cosmos World Foundation Model Platform for Physical AI. 2025.
- Wayve. GAIA-2: a controllable multi-camera world model for driving. 2025.