
Trio 소개 — 물리적 운영을 위한 월드 모델

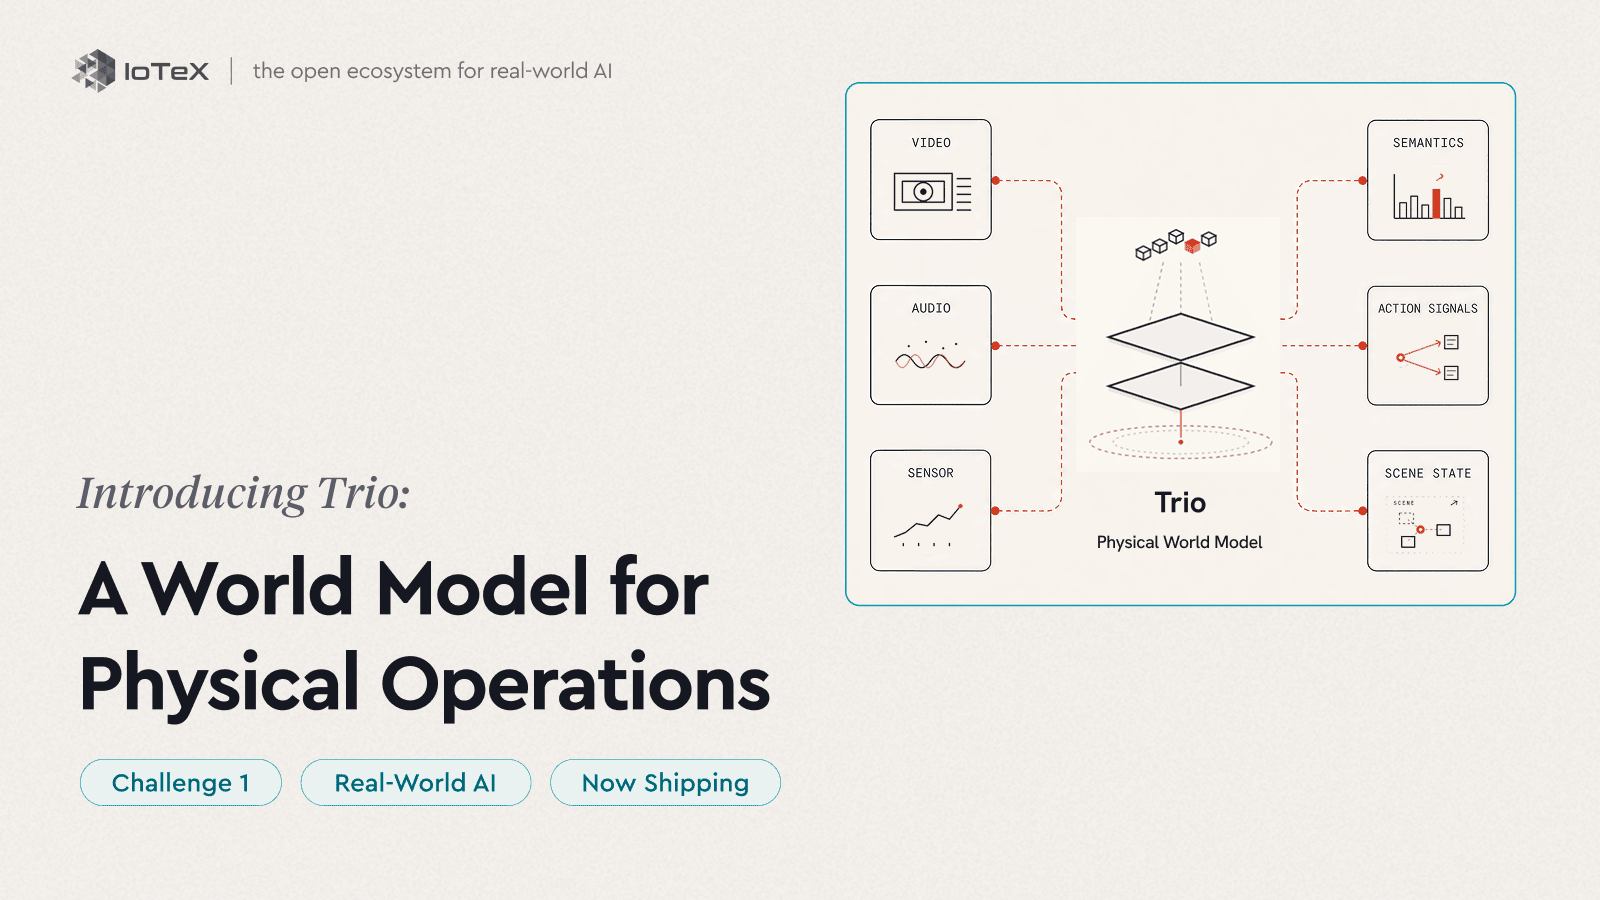
Trio, 현실 세계 AI, 그리고 안티로드맵의 첫 번째 도전 과제에 대한 우리의 답변에 관한 IoTeX 현황 업데이트입니다.
지난 3월, IoTeX는 2026년 안티로드맵을 발표했습니다 — 타임라인 대신 세 가지 도전 과제를 제시한 것입니다. 도전 과제 1은 존재론적인 것이었습니다: AI가 물리적 세계로 향하는 인터페이스가 되는 것. 우리의 답은 구체적이었습니다 — 비전을 최우선으로, 모든 실시간 스트림을 물리적 운영에 실시간으로 작동할 수 있는 지능으로 전환하는 것입니다. 그 답이 바로 Trio, IoTeX 핵심 팀이 MachineFi Lab에서 구축한 물리적 운영을 위한 세계 모델입니다. 우리는 그 도전을 받아들였고, 이제 그것을 선보입니다.
역사 전체를 통틀어, 물리적 세계는 사람에 의해 운영되어 왔습니다. 사람이 무슨 일이 일어나고 있는지 지켜보고, 그것이 무엇을 의미하는지 판단하고, 그에 따라 행동합니다 — 트럭을 운전하고, 라인에서 일하고, 현장을 순찰합니다. 인지, 예측, 행동: 이 루프에는 항상 사람이 필요했습니다.
AI는 먼저 디지털 세계를 바꿨습니다 — 언어, 코드, 이미지. 이제는 물리적 세계에서 시작하고 있습니다. 실시간 교통 상황 속에서 차를 운전하는 AI. 비디오 게임을 어떻게 플레이할지 상상하며 학습하는 AI. 빨래 더미를 개는 로봇. 이 모든 것의 근간이 되는 것 — 기계가 상황을 관찰하고, 다음에 무슨 일이 일어날지 상상하고, 그에 따라 행동할 수 있게 하는 것 — 이 바로 세계 모델입니다. Trio는 새로운 종류의 세계 모델입니다: AI에게 전체 운영 현장에 대한 실시간 시각을 부여하는 모델입니다.
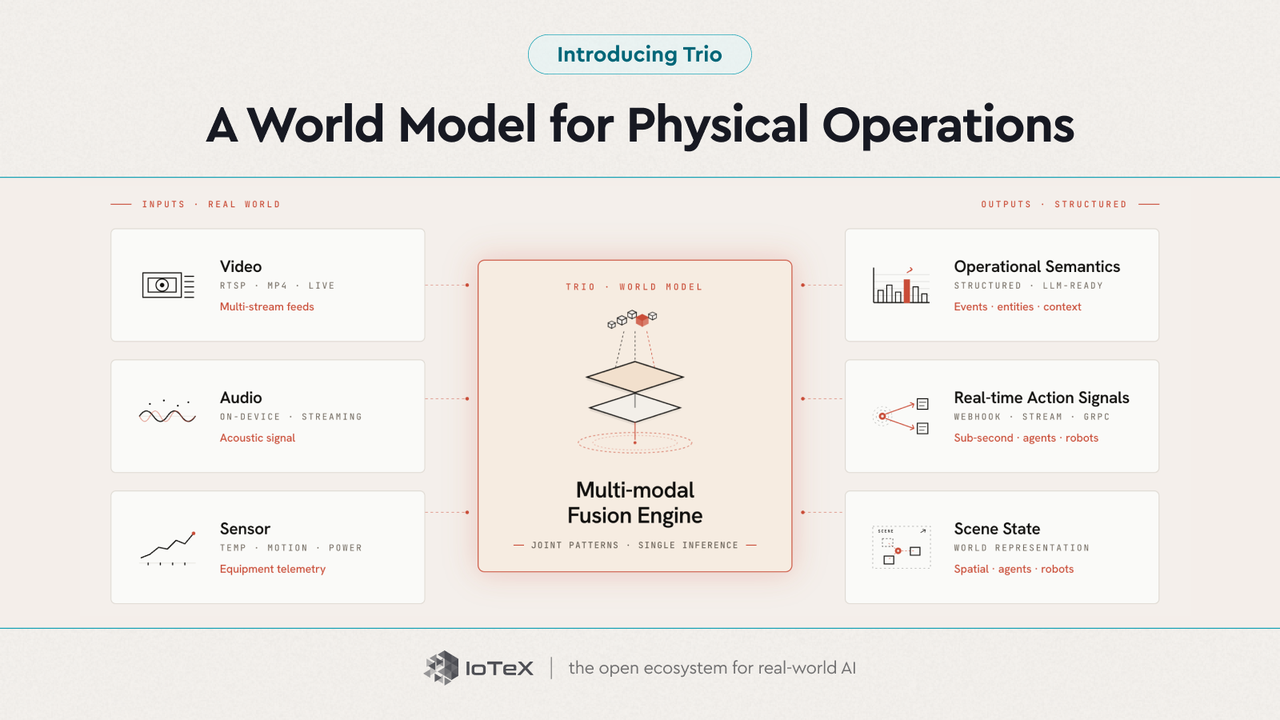
앞서 언급한 다른 사례들은 의도적으로 범위가 좁습니다: 자동차 한 대, 게임 하나, 로봇 하나, 작업 하나. 하지만 가장 넓은 물리적 표면은 이미 연결되어 관찰되고 있습니다 — 모든 창고, 매장, 공장, 케어 시설 위에 설치된 카메라들 말입니다… 이러한 것들 위에서, 전체 운영 현장을 실시간으로 다루는 세계 모델이야말로 도전 과제 1이 요구한 바로 그 인터페이스입니다. 그것이 바로 Trio가 만들어진 이유입니다.
Trio란 무엇인가
앞서 언급한 네 가지 사례의 공통점에 주목해보세요: 각각은 한 가지만 다룹니다 — 자동차 한 대, 게임 하나, 로봇 하나, 가상 세계 하나. 그중 어느 것도 운영(operation)을 다루지 않습니다. 그리고 물리적 경제의 대부분은 바로 거기에 존재합니다 — 점심 러시 시간의 레스토랑, 세차 베이를 통해 차량을 순환시키는 세차장, 트럭에 짐을 싣는 창고, 매장을 운영하는 상점, 공장 라인 — 수십 명의 사람, 차량, 기계가 한꺼번에 하루 종일 움직이는 곳들, 그리고 이 모든 것이 아무도 지켜볼 시간이 없는 카메라에 담깁니다.
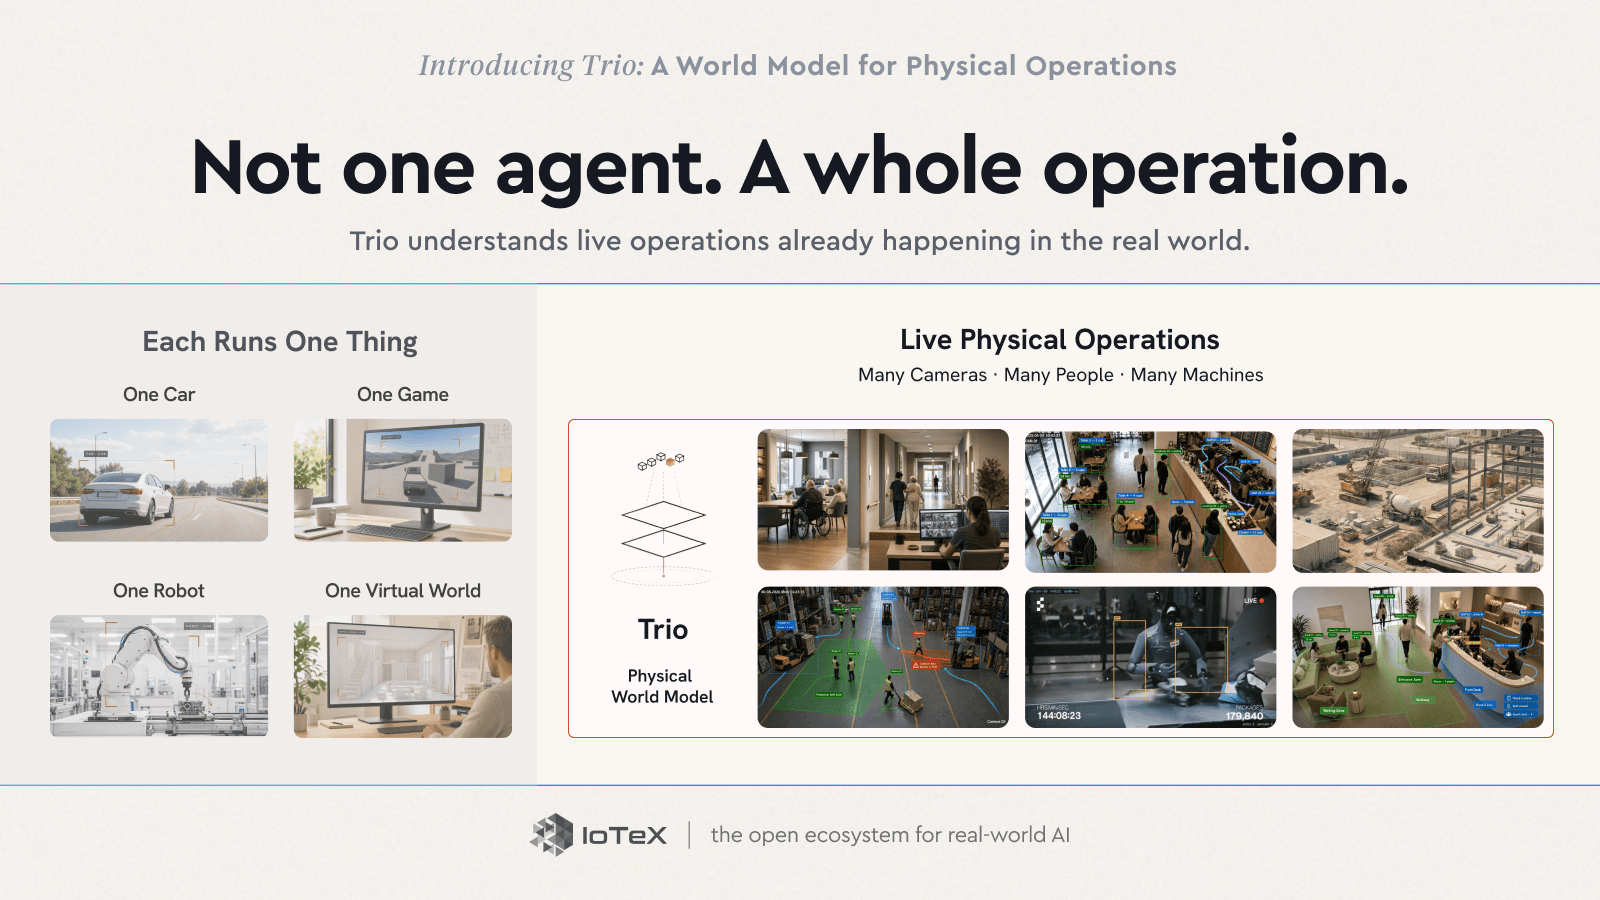
바로 그것을 위해 Trio가 존재합니다. Trio는 물리적 운영을 위한 우리의 세계 모델입니다 — 단일한 거대 모델이 아니라, 실시간 운영 현장을 함께 인지하고, 예측하고, 그에 따라 행동하는 세 가지 제품으로 이루어진 스위트입니다. 언어 모델이 텍스트가 작동하는 방식을 학습하는 것처럼, Trio는 여러분이 이미 보유한 카메라와 센서를 통해 장소가 작동하는 방식 — 그 안에 무엇이 있는지, 어떻게 움직이는지, 다음에 무슨 일이 일어날지 — 를 여러분의 운영 현장에 맞춰 학습합니다. 우리는 언어 모델을 대체하는 것이 아니라, 그들에게 물리적 세계를 제공합니다.
Trio는 이 루프를 세 단계로 실행합니다 — 그리고 그 순서대로 출시됩니다. 인지는 오늘 이미 실시간으로 작동하고 있으며, 예측과 행동은 다음 단계입니다.
인지 → 예측 → 행동
- 인지(Perception) — 보다 · 이해하다 — Trio-Retina · Trio-Lumen — 현재 실시간 운영 중
- 예측(Prediction) — 예견하다 · 미리 추론하다 — 다음 단계
- 행동(Action) — 루프를 완성하다 — 이후 단계
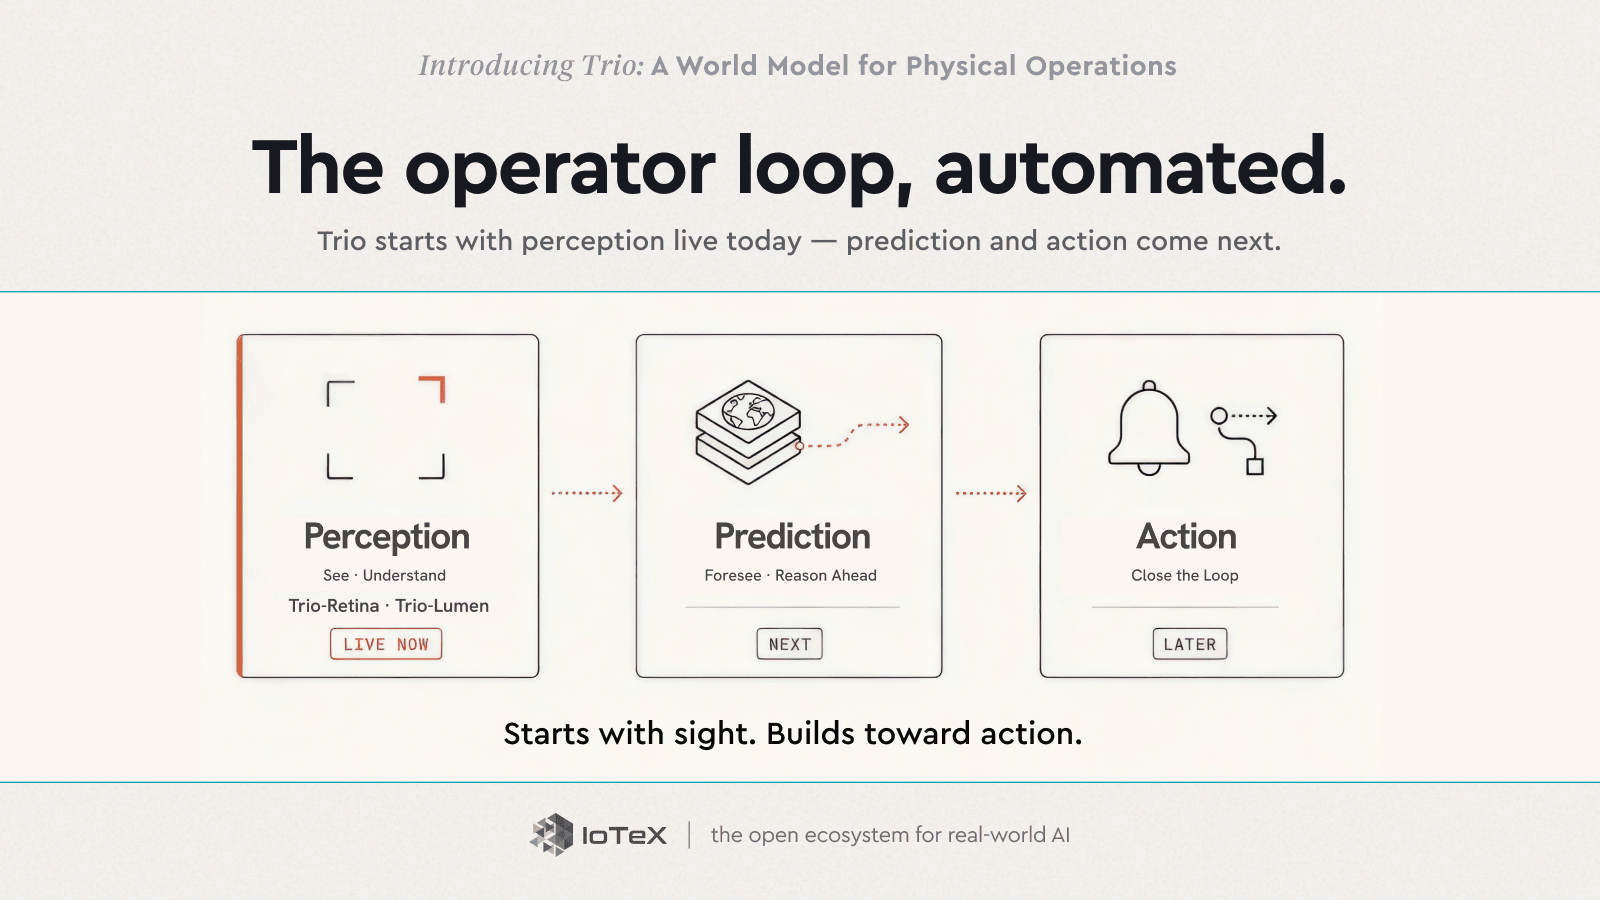
오늘, 이 중 두 가지는 이미 실현되어 여러분의 손안에 있습니다. Trio-Retina(보다)는 모든 카메라 피드를 무슨 일이 일어나고 있는지에 대한 하나의 표준화된 실시간 데이터로 전환합니다 — 누가 어디에 있는지, 무엇을 하고 있는지, 어디로 향하고 있는지. Trio-Lumen(이해하다)은 이를 평이한 영어로 프로그래밍 가능하게 만듭니다 — “근무 시간 이후 하역장에 있는 사람은 누구든 표시해줘”와 같이 — 매 프레임을 하루 종일 지켜보며 이벤트와 알림으로 전환합니다. 인지와 이해, 오늘 출시됩니다.
pip install trio-retinaTrio-Retina는 오픈소스입니다 — 자체 머신에서 실행하거나 Playground에서 직접 체험해보세요.
이 두 가지가 나머지의 기반이 되는 토대입니다. 예측과 행동 — 문제가 발생하기 전에 미리 예측하고, 현장에서 행동하는 것 — 은 루프의 다음 단계입니다. 이 순서는 의도적인 것입니다. 아직 보지 못하는 것을 예측할 수는 없기 때문에, 우리는 먼저 ’보는 것’을 구축했습니다.
오픈 인터넷으로 학습된 모델은 세상이 어떻게 생겼는지를 배웁니다. Trio는 여러분의 운영이 어떻게 돌아가는지를 배웁니다.
한 창고에서의 실제 모습
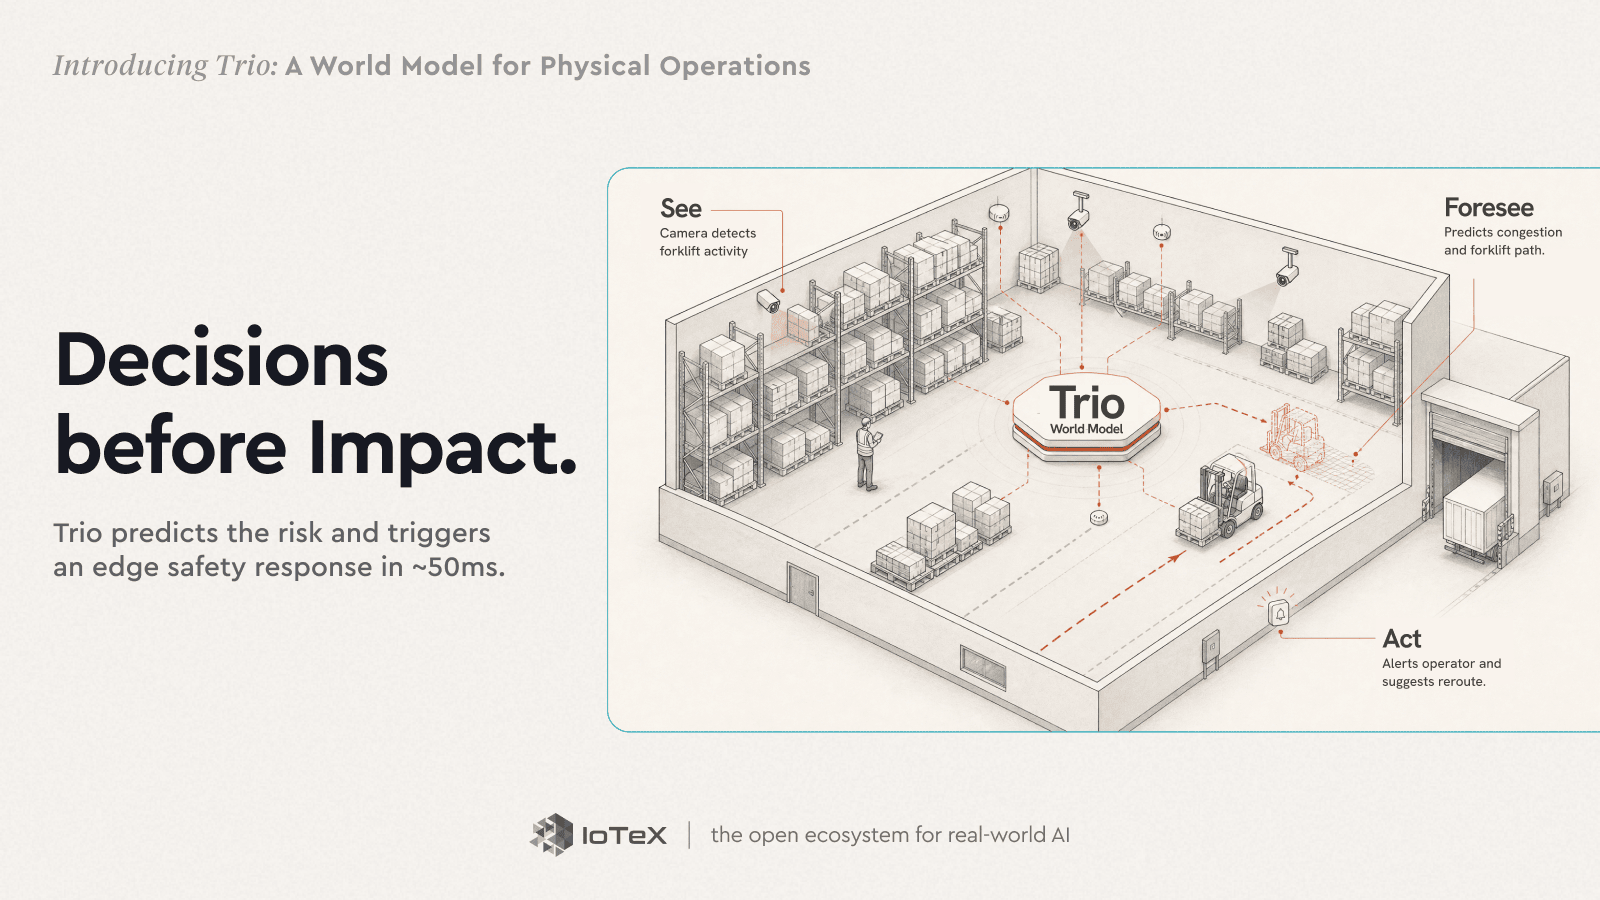
추상적인 설명을 걷어내고 살펴봅시다. 교대 근무 중인 하역장. 지게차가 베이에서 후진하고, 작업자는 두 선반 사이에서 그 경로를 가로지르는 길로 걸어 나옵니다. 아직 서로를 보지 못한 상태입니다.
보기(See) — 카메라 옆의 작은 박스에서 실행되는 Trio-Retina는 이미 지게차와 사람을 추적 객체로 인식하고, 이들의 위치와 향하는 방향을 파악하고 있습니다.
예측하기(Foresee) — Trio의 세계 모델이 다음 2초를 시뮬레이션합니다. 두 경로가 교차합니다. 이 정확한 기하학적 상황이 과거에 나쁜 결과로 이어진 적이 있음을 이미 학습한 상태입니다.
행동하기(Act) — 결정론적 엣지 안전 게이트가 약 50밀리초 만에 교차 알람을 울립니다 — 사람이 반응할 수 있는 것보다 빠릅니다 — 그리고 지게차에 정지 신호가 전달됩니다. 사고 보고서 대신 아찔한 상황(near-miss)으로 끝납니다.
이것이 단 한 프레임에 담긴 전체 논지입니다. 무언가가 일어난 후에 다시 꺼내보는 영상이 아니라, 일이 벌어지기 바로 그 직전에 내려지는 결정입니다.
진짜 세계 모델 — 그리고 우리 모델이 다른 점
Trio는 빠르게 발전하는 분야에 속해 있습니다. 세계 모델(world model)은 지금 AI 분야 최고의 두뇌들이 주목하고 있는 지점입니다. 이 아이디어는 Ha와 Schmidhuber의 World Models(2018)로 거슬러 올라갑니다 — 에이전트가 자신이 처한 환경의 압축된 모델을 학습하고 그 안에서 “꿈을 꾸듯” 롤아웃을 실행한다는 개념입니다. Yann LeCun은 잠재 공간(latent space)에서의 예측적 세계 모델(그의 JEPA)이 자율적 기계 지능으로 가는 길에서 빠진 마지막 퍼즐 조각이라고 주장합니다. Fei-Fei Li는 이 프런티어를 공간 지능(spatial intelligence)이라고 부르며, 그녀의 World Labs는 탐험 가능한 3D 세계를 생성하는 모델을 만듭니다. 이 분야는 대략 다음과 같은 진영으로 나뉩니다.
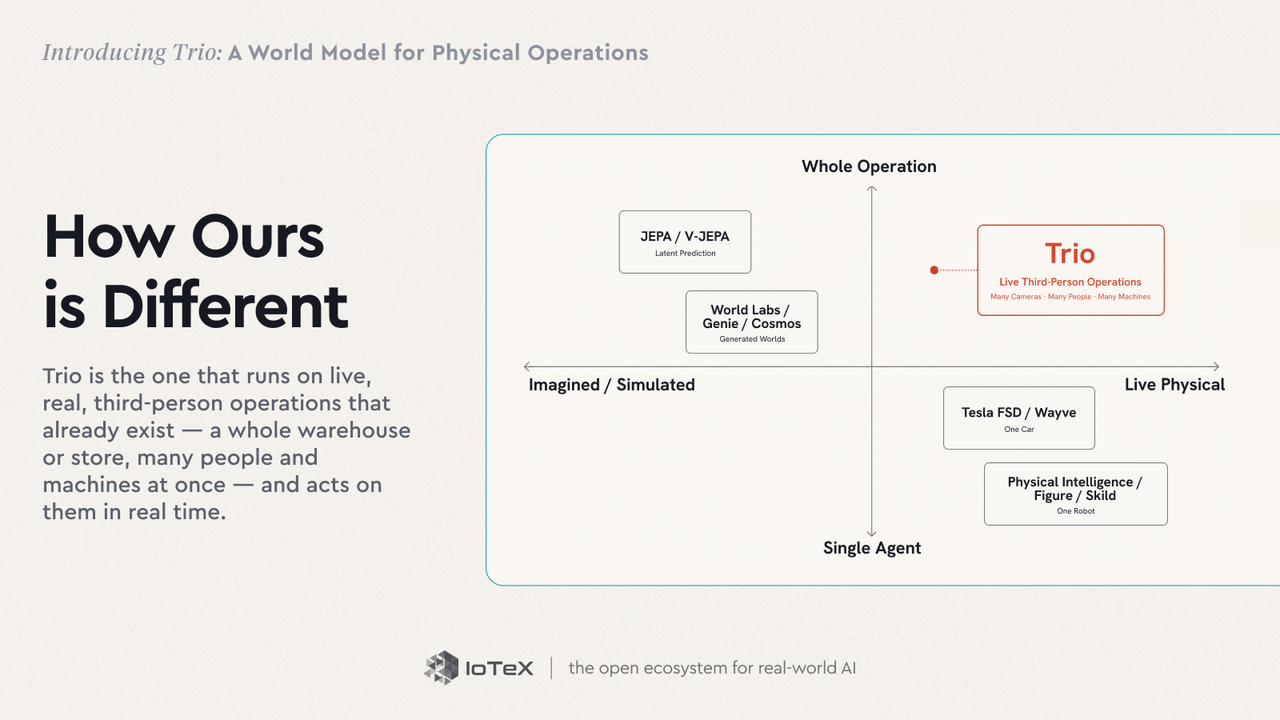
- 잠재 예측(Latent prediction) — V-JEPA 2(Meta)와 Dreamer 계열은 잠재 공간에서 동역학을 학습하고 그 안에서 계획을 세웁니다.
- 생성형 및 상호작용형 세계(Generative & interactive worlds) — Genie 3(DeepMind), NVIDIA Cosmos, World Labs의 Marble은 환경을 상상하고 생성합니다.
- 주행(Driving) — Tesla FSD와 Wayve의 GAIA-2는 지구상에서 가장 많이 배포된 세계 모델을 실행합니다 — 단 한 대의 차량을 위해서요.
- 로보틱스(Robotics) — Physical Intelligence, Skild AI, Figure는 단 하나의 로봇을 위한 파운데이션 모델을 구축합니다.
이들 거의 모두는 세계를 상상하거나 시뮬레이션하거나, 단일 에이전트의 자기중심적 영역 — 한 대의 차, 한 대의 로봇 — 을 모델링합니다. Trio는 이미 존재하는 실시간, 실제, 3인칭 관점의 운영 환경 — 창고나 매장 전체, 동시에 존재하는 여러 사람과 기계 — 위에서 작동하며, 실시간으로 그에 따라 행동하는 유일한 모델입니다.
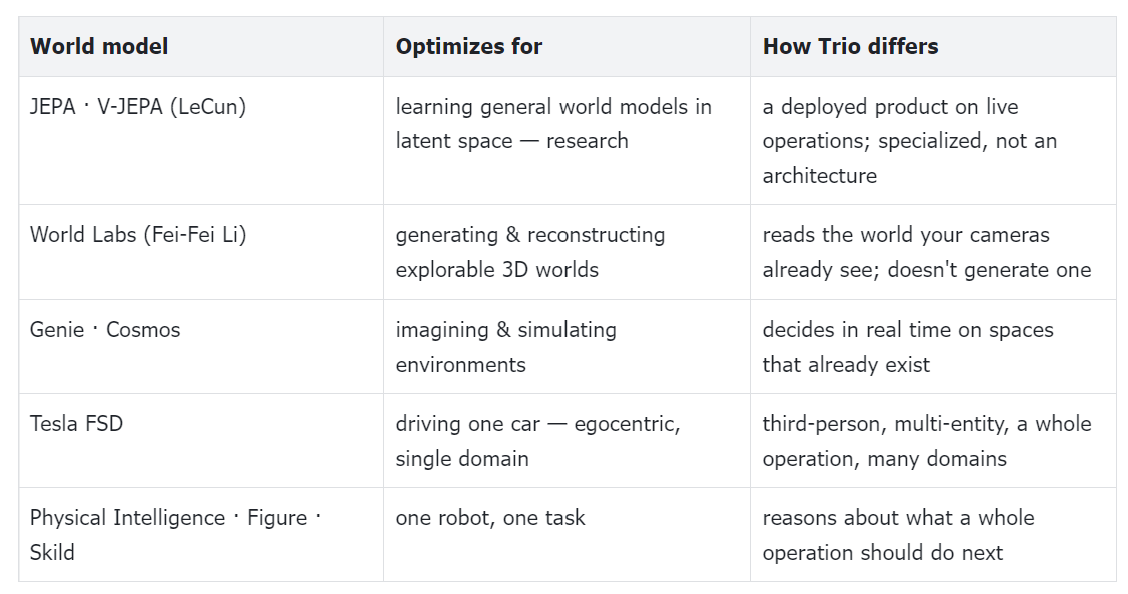
Trio를 차별화하는 두 가지 축이 있습니다. 기술적으로 — 작고, 빠르고, 특화되어 있습니다: 엣지에서 실시간으로 작동하며, 쿼리당 최저 $0.004에 결정 단위로 과금되고, 모든 프레임마다 거대한 범용 모델을 다시 실행하는 대신 고정된 기반 모델에 소규모 사이트별 어댑터(LoRA, GPU 시간 단위로 학습)를 결합합니다. OVBench 스트리밍 벤치마크에서 오픈 웨이트 모델을 Trio 스택으로 감싸면 순전히 아키텍처만으로 정확도가 +2.3포인트 상승하며, 프론티어 모델들이 한계로 두는 고정된 분(minute) 제한 없이 인식이 스트리밍됩니다. 시나리오별로 — 이미 존재하는 운영 위에서 작동하며, 하나의 세계를 상상하거나, 한 대의 차를 운전하거나, 한 대의 로봇을 움직이는 대신 지금 바로 그 운영에 대해 행동합니다.
Trio는 어떻게 만들어졌는가
기술팀을 위한 설명: Trio가 모든 카메라에서 하루 종일 실행될 만큼 빠르고 저렴하게 유지되는 방법입니다. 운영 이야기를 보러 오셨다면 훑어보세요 — 핵심은 마지막 줄에 있습니다.
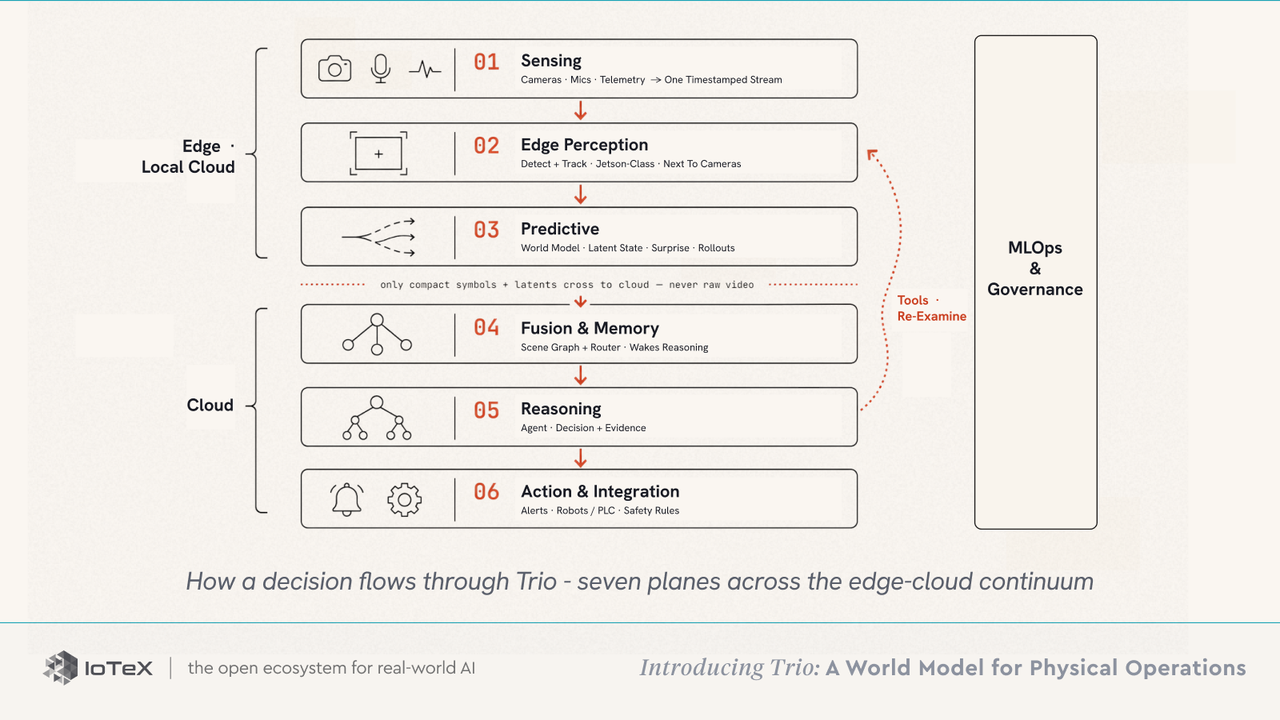
다섯 가지 원칙이 시스템을 하나로 묶습니다: 계층 간 모든 인터페이스는 강타입이며 검사 가능한 씬 그래프입니다(불투명한 벡터가 아님); 라우터가 비용을 관장하여 저렴한 계층은 지속적으로 실행하고, 필요할 때만 값비싼 추론을 깨웁니다; 도구는 양방향으로, 추론 계층이 하위 계층에 재검토나 재시뮬레이션을 명령할 수 있습니다; 모든 결정에는 그 근거가 함께 제공되어 운영자가 이를 검토, 이의 제기, 무효화할 수 있습니다; 그리고 기반 모델은 고정된 채로 유지되며, 소규모 배포별 어댑터 — LoRA 모듈과 교차 계층 융합 어댑터, 전체 재학습이 아닌 GPU 시간 단위로 학습됨 — 가 각 사이트를 특화합니다.
이러한 원칙들은 일곱 개의 플레인으로 구현됩니다 — 단일 결정의 경로에 여섯 개, 그리고 전체를 아우르는 거버넌스 하나: 센싱(카메라 · 마이크 · 텔레메트리 → 하나의 타임스탬프된 스트림) → 엣지 인식(감지 + 추적, Jetson급, 카메라 옆에서) → 예측(월드 모델: 잠재 상태 · 놀라움 · 롤아웃) → 융합 & 메모리(씬 그래프 + 추론을 깨우는 라우터) → 추론(에이전트 → 근거와 짝지어진 결정) → 행동 & 통합(경보 · 로봇 / PLC · 독립적인 안전 규칙), 그리고 이 모든 것을 아우르는 MLOps & 거버넌스.
인식과 예측이 로컬에서 실행되고 압축된 심볼과 잠재 정보만 클라우드로 전송되므로 — 원본 영상은 절대 전송되지 않습니다 — Trio는 프레임당 토큰이 아니라 결정 단위로 과금됩니다.
Trio가 실행되는 곳
창고는 하나의 사례였을 뿐입니다. 레스토랑, 세차장, 매장, 그리고 우리가 처음 시작한 공장까지 — 동일한 모델이 카메라로 운영되는 모든 사업장에 적용되며, 오늘날 인간 운영자와 함께 작동하면서 기존 시스템이 놓치는 것들을 드러냅니다:
- 프랜차이즈 운영 — 대기열 관리, 손실 감소, 직원 준수 여부, 고객 흐름 분석.
- 보안 & 출입 관리 — 침입 탐지, 배회 분석, 무단 동승 방지, 시간 외 단속.
- 물류 & 창고 관리 — 도크 상태, 차량 체류 시간, PPE 준수, 마당과 작업장 전반의 안전 SOP 시행.
- 제조 & 산업 — 라인 모니터링, 결함 감지, 모든 라인과 기계 구역의 위험 경보.
- 스마트 시티 — 주차, 교통 흐름, 공공 안전, 도로와 대중교통 전반의 인프라 모니터링.
- 헬스케어 & 생명과학 — 낙상 감지, 점유 패턴, 입주자 방과 시설 전반의 행동 모니터링.
- 호스피탈리티 & 행사장 — 군중 관리, VIP 구역 출입 통제, 대규모 실시간 사고 대응.
- 핵심 인프라 — 24시간 경계 인텔리전스, 침입 탐지, 경보를 놓칠 수 없는 사이트를 위한 자율 대응.
우리가 구축한 것 — 그리고 다음 단계
Trio는 더 이상 화이트보드 위의 이론이 아닙니다. v1.0 기술 보고서는 전체 시스템 — 인식-예측-행동 스택, 다섯 가지 원칙, 일곱 개의 플레인 — 을 공식화하며, 완전히 구현된 두 가지 참조 도메인(세차장과 창고)을 다루고, 위에서 언급한 지게차와 보행자의 아차사고까지 다룹니다. 이는 100ms 한계 내에서 약 50밀리초 만에 작동하는 결정론적 엣지 안전 게이트가 포착한 사례입니다. Trio-Retina는 오픈 소스이며(pip install trio-retina), 플레이그라운드도 공개되었습니다 — 지금 열어서 브라우저에서 Trio가 실제 영상을 읽는 모습을 확인해보세요.
세 가지 힘이 지금 이 순간을 만들고 있습니다. 엣지 실리콘은 이제 클라우드 왕복 없이도 실시간 운영 추론을 수행할 수 있게 되었고, 다중 개체 장면 이해는 단일 객체 탐지가 결코 도달하지 못했던 연구의 문턱을 넘어섰으며, 물리적 환경을 운영하는 이들은 오늘날 AI에서 가장 저평가된 역량일지도 모르는 것—새로운 하드웨어 없이 이미 보유한 카메라 위에 구축되는 월드 모델—을 받아들일 준비가 되어 있습니다. 여기서부터 Trio는 루프를 따라 성장합니다. 오늘의 보고 이해하는 단계에서 앞으로 예측하고, 나아가 현장에서 행동하는 단계로 나아갑니다.
오늘 Trio로 시작하기
두 가지 시작 방법—둘 다 지금 바로 이용 가능합니다.
직접 구축하기 · 개발자용 — GitHub의 Trio-Retina. 오픈소스 인식 레이어—어떤 탐지기든 이벤트와 잠재 상태로 이루어진 하나의 표준 스트림으로 바꾸어 주는 모델에 구애받지 않는 상태 레이어입니다. pip install trio-retina를 실행하고 본인의 머신에서 직접 구동해보세요.
체험해보기 · 운영자용 — 플랫폼의 Trio-Lumen. 브라우저에서 당신의 운영 현장이 살아 움직이는 것을 확인하세요—Trio가 실제 영상을 상태를 지닌 객체로, 군중을 흐름으로 읽어내는 모습을 보고, 이후 당신의 카메라를 직접 연결해 평이한 언어로 질문해보세요.
Trio, IoTeX, 그리고 머신 이코노미
Trio는 아무것도 없는 곳에서 나온 것이 아닙니다. 10년에 걸친 IoTeX의 토대 위에 구축되었습니다—인프라와 연결 기기 네트워크, 기기 아이덴티티(ioID), 검증 가능한 머신 데이터(Quicksilver), 그리고 실세계 AI가 데이터와 아이덴티티, 신뢰를 바탕으로 세상에 자리 잡기 위해 필요한 머신 간 결제(x402)까지. 그리고 Trio는 IoTeX의 비전을 구체화하는 제품입니다. Challenge 1은 IoTeX를 AI가 물리적 세계를 보고, 검증하고, 행동하는 인터페이스로 만드는 것을 목표로 했으며, Trio가 바로 그 ‘보는’ 부분입니다.
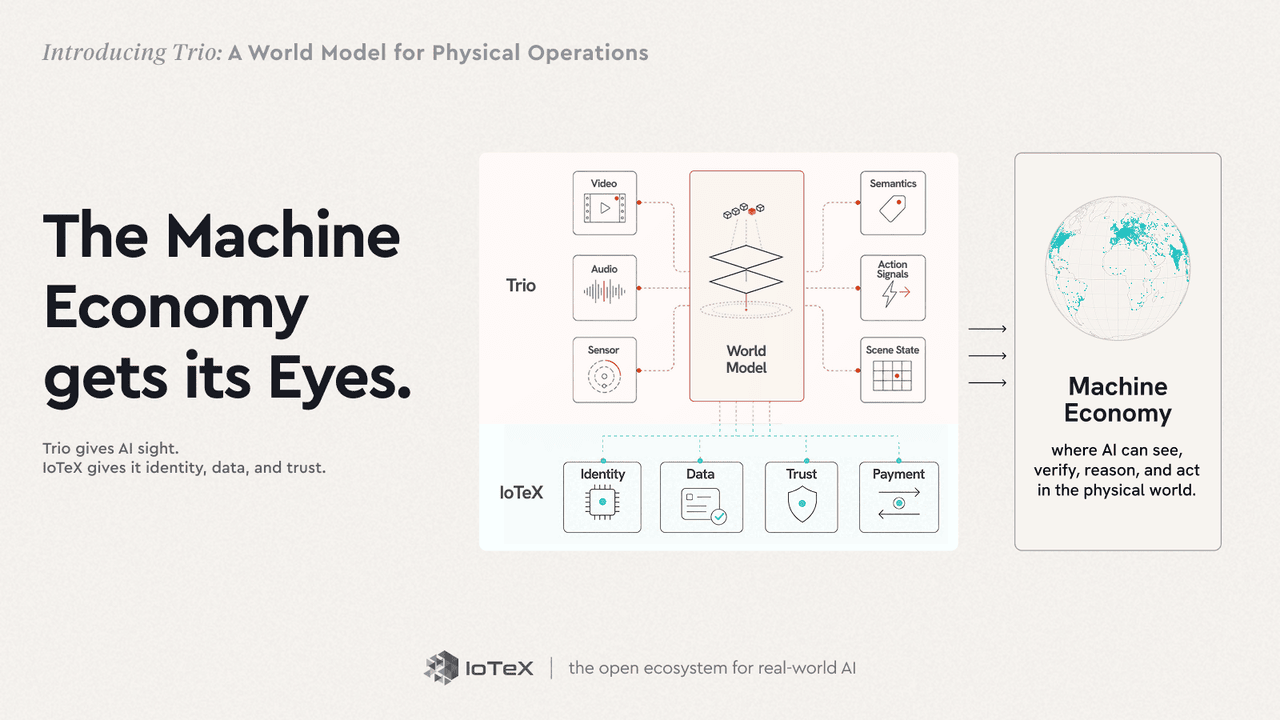
이 모든 것을 합치면 Anti-Roadmap이 설명했던 머신 이코노미가 완성됩니다. 기계에게는 세 가지가 필요합니다. 세상을 보는 것, 보는 것을 신뢰하는 것, 그리고 그것에 대해 행동하는 것입니다. IoTeX는 탈중앙화된 신뢰를 제공하고, Trio는 물리적 현실을 지각하는 눈과 귀, 그리고 그것을 추론하고 행동으로 옮기는 두뇌를 제공합니다.
계속 나아갑니다…
Challenge 1은 이제 답을 찾았습니다. AI에게 물리적 세계를 보는 눈을 주고 이를 현실로 만드는 것—이것이 우리 2026 Anti-Roadmap의 첫 번째이자 가장 본질적인 과제였습니다. 우리는 그 길을 찾았고, 그 이후로 전속력으로 구축해 왔습니다. Trio는 슬라이드웨어가 아닌, 실제로 출시되는 실세계 AI입니다—이미 설치되어 있는 카메라 위에서 작동하며 첫날부터 가치를 만들어냅니다.
공식 출시가 가까워지고 있으며, 우리가 약속했던 미래가 거의 우리 손안에 있습니다. 저희와 함께 만들어 주시고 계속 지켜봐 주셔서 감사합니다.
— IoTeX 팀 드림
월드 모델에 관한 더 읽을거리
- D. Ha, J. Schmidhuber. World Models. 2018.
- Y. LeCun. A Path Towards Autonomous Machine Intelligence. 2022. (JEPA 소개)
- F.-F. Li. From Words to Worlds: Spatial Intelligence is AI’s Next Frontier. 2025. (World Labs)
- D. Hafner, W. Yan, T. Lillicrap. Training Agents Inside of Scalable World Models (DreamerV4). 2025.
- Meta AI. V-JEPA 2. 2025.
- DeepMind. Genie 3. 2025.
- NVIDIA. Cosmos World Foundation Model Platform for Physical AI. 2025.
- Wayve. GAIA-2: a controllable multi-camera world model for driving. 2025.